
Vous venez de Postgres 18 ? Ce qu’il faut changer pour Postgres 17
Relyt One fonctionne sous PostgreSQL 17. Si votre schéma ou vos habitudes viennent de Postgres 18, voici ce qui échoue sur 17, ce qu’il faut écrire à la place et comment charger un dump réalisé sur 18, chaque extrait ayant été exécuté sur les deux versions.
Sur cette page

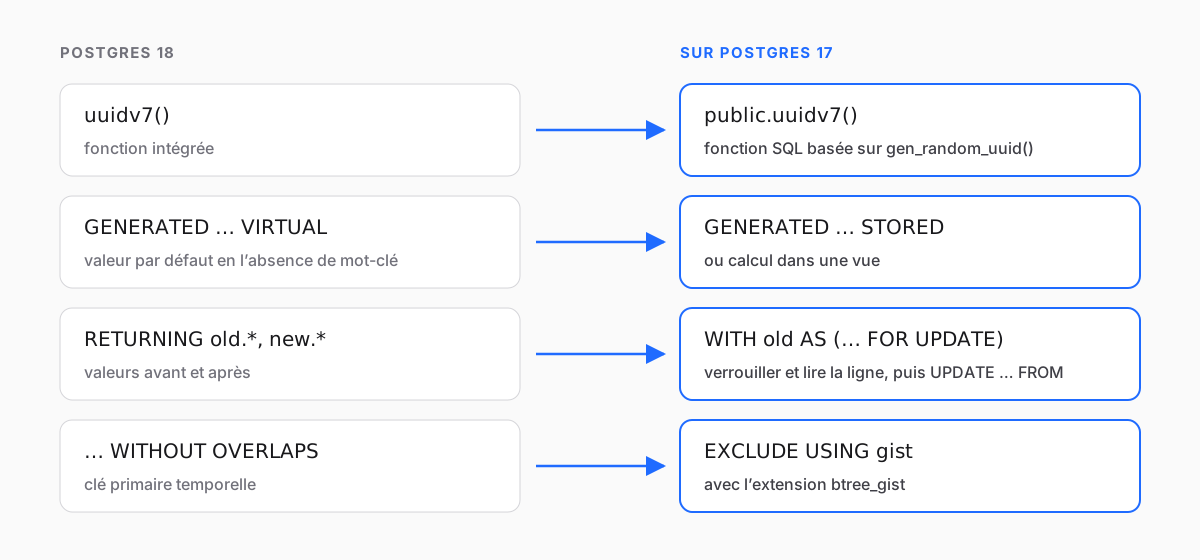
Relyt One fonctionne sous PostgreSQL 17. Postgres 18 est sorti en septembre 2025, si bien que beaucoup de nouveaux projets, de tutoriels et de schémas générés par IA s’appuient désormais sur des fonctionnalités propres à 18 : uuidv7(), les colonnes générées virtuelles, OLD et NEW dans RETURNING, les clés primaires temporelles. Sur 17, chacune d’elles provoque une erreur. Cet article recense ce qui échoue, propose pour chaque cas un remplacement qui fonctionne dès aujourd’hui sur 17 et détaille le chargement d’un dump réalisé sur 18. Nous avons exécuté chaque extrait sur PostgreSQL 17.5 et 18.6 ; les sorties affichées sont celles que nous avons obtenues.
Rien de tout cela n’est exotique. La plupart des schémas n’utilisent aucune de ces fonctionnalités, et ceux qui les utilisent n’en emploient généralement qu’une ou deux. L’enjeu est de les repérer avant qu’une migration n’échoue à mi-parcours, pas après.
SELECT version();
SHOW server_version_num;   -- 170005 signifie 17.5 ; tout ce qui commence par 17 est Postgres 17
Si votre code doit adapter son comportement à la version à l’exécution, comparez server_version_num numériquement (>= 180000), et non la chaîne renvoyée par version().
Postgres 18 a ajouté uuidv7(), qui génère des UUID ordonnés dans le temps. Ils font de meilleures clés primaires que les UUID aléatoires de version 4, car les nouvelles lignes arrivent à la fin de l’index au lieu de s’éparpiller partout. Sur 17 :
ERROR: function uuidv7() does not existVous pouvez générer le même format en SQL. Un UUID de version 7 est un horodatage Unix de 48 bits en millisecondes suivi de bits aléatoires, avec les bits de version et de variante positionnés. gen_random_uuid() (intégré depuis Postgres 13, sans extension) fournit déjà les bits aléatoires et la variante ; la fonction écrase donc les six premiers octets avec l’horodatage et inverse deux bits pour faire passer la version de 4 à 7 :
CREATE FUNCTION public.uuidv7() RETURNS uuid
LANGUAGE sql VOLATILE
AS $$
  -- temps Unix sur 48 bits en ms, puis version 7 sur les bits aléatoires d’un UUID v4
  SELECT encode(
    set_bit(set_bit(
      overlay(uuid_send(gen_random_uuid())
              PLACING substring(int8send(floor(extract(epoch FROM clock_timestamp()) * 1000)::bigint) FROM 3)
              FROM 1 FOR 6),
      52, 1), 53, 1),
    'hex')::uuid;
$$;

CREATE TABLE events (
  id   uuid PRIMARY KEY DEFAULT public.uuidv7(),
  body text
);
Depuis Postgres 15, seul le propriétaire de la base de données peut créer des objets dans public par défaut ; exécutez donc ceci en tant que propriétaire (ou placez la fonction dans un schéma qui vous appartient). Nous avons vérifié 10 000 valeurs générées : chacune porte la version 7 et la variante RFC 9562, et l’horodatage intégré correspondait à l’horloge du serveur. La fonction utilise clock_timestamp() plutôt que now(), de sorte que les lignes insérées plus tard dans la même transaction reçoivent quand même des horodatages postérieurs.
Il existe une vraie différence. La fonction intégrée de 18 renseigne aussi une partie inférieure à la milliseconde, et dans notre test, 1 000 valeurs générées en une seule instruction sur 18 sont sorties dans un ordre strictement croissant. La version SQL ordonne les valeurs d’une milliseconde à l’autre, mais pas à l’intérieur d’une même milliseconde : les valeurs générées dans la même milliseconde sont dans un ordre aléatoire. Pour la localité de l’index, cela n’a pas d’importance. Si votre code suppose que les identifiants d’une même session sont strictement croissants, utilisez plutôt une séquence pour l’ordre.
Un piège voisin : uuid_extract_timestamp() existe dans 17, mais n’y comprend que les UUID de version 1 et renvoie NULL pour la version 7. Postgres 18 a ajouté la prise en charge de la version 7. Sur 17, extrayez l’horodatage vous-même :
CREATE FUNCTION public.uuidv7_timestamp(u uuid) RETURNS timestamptz
LANGUAGE sql IMMUTABLE STRICT
AS $$
  SELECT to_timestamp(('x' || substr(replace(u::text, '-', ''), 1, 12))::bit(48)::bigint / 1000.0);
$$;

SELECT public.uuidv7_timestamp('019535d9-3df7-79fb-b466-fa907fa17f9e');
-- 2025-02-24 02:46:24.503+00, la même valeur que renvoie uuid_extract_timestamp() sur 18
Contrairement à la fonction intégrée, cette fonction d’aide ne vérifie pas la version : donnez-lui un UUID de version 4 et elle renvoie une date dénuée de sens au lieu de NULL. Ne l’appelez que sur des identifiants dont vous savez qu’ils sont de version 7.
Dans 18, une colonne générée est calculée à la lecture, sauf indication contraire. VIRTUAL est la nouvelle valeur par défaut, et STORED correspond à l’ancien comportement. 17 ne connaît que les colonnes générées stockées, et exige le mot-clé. Ces deux instructions échouent sur 17 :
CREATE TABLE product (price_cents int, price numeric GENERATED ALWAYS AS (price_cents / 100.0) VIRTUAL);
-- ERROR:  syntax error at or near "VIRTUAL"

CREATE TABLE product (price_cents int, price numeric GENERATED ALWAYS AS (price_cents / 100.0));
-- ERROR:  syntax error at or near ")"
La seconde compte plus qu’il n’y paraît : sur 18, elle est valide et signifie virtuelle, si bien que les schémas écrits pour 18 n’ont souvent aucun mot-clé. Deux remplacements :
-- Option A : la stocker. Même colonne, mêmes requêtes ; coûte de l’espace disque et du temps d’écriture.
CREATE TABLE product (
  price_cents int,
  price       numeric GENERATED ALWAYS AS (price_cents / 100.0) STORED
);

-- Option B : garder une table légère et calculer dans une vue.
CREATE TABLE product_base (price_cents int);
CREATE VIEW product AS
  SELECT *, price_cents / 100.0 AS price FROM product_base;
Une vue simple comme celle-ci est automatiquement modifiable, donc INSERT INTO product (price_cents) VALUES (1999) fonctionne toujours à travers elle. Nous l’avons essayé sur 17. Choisissez A, sauf si l’expression est lourde ou si la table subit beaucoup d’écritures.
18 permet à RETURNING de désigner la ligne avant et après une modification :
UPDATE acct SET balance = balance - 30 WHERE id = 1
RETURNING old.balance AS before, new.balance AS after;
Sur 17, cela échoue avec missing FROM-clause entry for table "old". Pour obtenir les valeurs précédentes, lisez et verrouillez la ligne dans une CTE, puis faites une jointure avec elle dans l’UPDATE :
WITH old AS (
  SELECT id, balance FROM acct WHERE id = 1 FOR UPDATE
)
UPDATE acct a SET balance = a.balance - 30
FROM old
WHERE a.id = old.id
RETURNING old.balance AS before, a.balance AS after; before | after
--------+-------
100 | 70C’est FOR UPDATE qui rend cette approche correcte : il verrouille la ligne avant que la mise à jour ne la lise, de sorte qu’une modification concurrente ne peut pas s’intercaler entre les deux et rendre before mensonger. Sans lui, en cas de concurrence, vous pouvez renvoyer une valeur « before » qui n’a jamais été l’état de la ligne au moment de votre mise à jour. Pour DELETE, un simple RETURNING * renvoie déjà l’ancienne ligne. Pour INSERT … ON CONFLICT DO UPDATE, il n’existe pas d’équivalent propre sur 17 pour les anciennes valeurs. Si vous en avez besoin, sélectionnez-les d’abord avec FOR UPDATE, ou gardez un trigger d’audit. Sélectionner d’abord n’aide pas quand la ligne n’existe pas encore : il n’y a rien à verrouiller, donc une insertion concurrente peut toujours s’intercaler.
18 peut imposer, sous forme de clé primaire, la règle « pas deux lignes pour la même salle avec des plages horaires qui se chevauchent » :
-- sur 18, il faut aussi btree_gist, car room est un simple int
CREATE TABLE booking (room int, during tstzrange, PRIMARY KEY (room, during WITHOUT OVERLAPS));
-- sur 17 : ERROR:  syntax error at or near "WITHOUT"
La garantie elle-même est disponible depuis des années sous la forme d’une contrainte d’exclusion. Combiner une simple colonne d’égalité (room) et une plage dans un même index GiST nécessite l’extension btree_gist, qui est marquée comme fiable (trusted) : tout rôle disposant de CREATE sur la base de données (le propriétaire l’a) peut donc l’installer sans droits de superutilisateur :
CREATE EXTENSION IF NOT EXISTS btree_gist;

CREATE TABLE booking (
  room   int       NOT NULL,
  during tstzrange NOT NULL CHECK (NOT isempty(during)),
  EXCLUDE USING gist (room WITH =, during WITH &&)
);

INSERT INTO booking VALUES (101, '[2026-11-10 09:00Z, 2026-11-10 10:00Z)');
INSERT INTO booking VALUES (101, '[2026-11-10 10:00Z, 2026-11-10 11:00Z)');  -- ok : contiguës, sans chevauchement
INSERT INTO booking VALUES (101, '[2026-11-10 09:30Z, 2026-11-10 10:30Z)');
-- ERROR:  conflicting key value violates exclusion constraint "booking_room_during_excl"
Le CHECK est important : 18 rejette les plages vides dans une clé WITHOUT OVERLAPS, mais une plage vide ne chevauche jamais rien, donc sans cette vérification la contrainte d’exclusion en accepterait autant qu’on veut. Vérifiez que l’extension est disponible sur votre base de données avec SELECT * FROM pg_available_extensions WHERE name = 'btree_gist';. Nous avons confirmé qu’elle est livrée, en version 1.7, dans l’image de calcul Relyt One que nous avons testée. Ce que 17 ne sait pas faire, c’est l’autre moitié de la fonctionnalité : les clés étrangères temporelles (FOREIGN KEY (…, PERIOD …)). Il n’existe pas d’équivalent déclaratif. Faites-les respecter dans un trigger ou dans l’application, et testez-les, car il est facile de se tromper aux bornes d’une plage.
Plusieurs des fonctionnalités phares de 18 touchent aux performances ou à l’exploitation, pas au SQL. Votre schéma et vos requêtes ne les mentionnent pas, il n’y a donc rien à réécrire :
- Les E/S asynchrones accélèrent sur 18 les parcours séquentiels, les parcours de tas bitmap et le vacuum. Sur 17, les mêmes requêtes fonctionnent et utilisent des E/S synchrones.
- Le skip scan permet à 18 d’utiliser un index B-tree multicolonne même lorsque la requête ne filtre pas sur la première colonne. Si une requête sur 17 ne filtre que sur la deuxième colonne de
(tenant_id, created_at), elle risque de ne pas utiliser cet index. Examinez le plan avecEXPLAIN, et ajoutez un index qui commence par la colonne filtrée si cela compte. - L’authentification client OAuth est une nouveauté de 18. Vous vous connectez à Relyt One avec le mot de passe du rôle via TLS, en utilisant la chaîne de connexion fournie par la console avec
sslmode=require. - La dépréciation des mots de passe MD5 dans 18 n’a aucun effet sur les schémas 17.
La documentation de pg_dump est explicite : sa sortie est censée se charger dans des serveurs plus récents, et le chargement dans une version majeure plus ancienne « n’est pas garanti » et « peut nécessiter une modification manuelle du fichier de dump ». Passer de 18 à 17 relève précisément de ce cas. Voici la procédure que nous avons suivie, et ce qui a cassé en chemin.
Utilisez un psql 17.6 ou plus récent pour le charger. Les dumps produits par le pg_dump actuel commencent par une ligne \restrict, une méta-commande psql ajoutée dans 17.6 pour un correctif de sécurité (CVE-2025-8714) et incluse dans toutes les versions de Postgres 18. psql 17.5 la rejette avec invalid command \restrict. Avec ON_ERROR_STOP=1, le chargement s’interrompt à cet endroit ; sans cette option, psql continue et saute silencieusement la protection que \restrict est censé apporter. Utilisez un client 18.x ou 17.6+ : psql 18 se connecte sans problème à un serveur 17.
Exportez le schéma et les données séparément, sans propriétaires ni droits, puisque les rôles de la cible seront différents :
pg_dump "$SOURCE_URL" --schema-only --no-owner --no-privileges --quote-all-identifiers > schema.sql
pg_dump "$SOURCE_URL" --data-only   --no-owner --no-privileges --quote-all-identifiers > data.sql
--quote-all-identifiers est ce que recommande la documentation de pg_dump pour les chargements entre versions : cela évite les surprises dues aux mots réservés dans une version et pas dans l’autre. Charger les données après le schéma complet signifie que les index, les clés étrangères et les triggers existent déjà pendant le chargement. C’est plus lent qu’un dump unique, et vos propres triggers se déclenchent pour chaque ligne. Pour une base de données volumineuse, découpez plutôt avec --section=pre-data, data et post-data, et ne modifiez que le fichier pre-data.
Repérez la syntaxe propre à 18 avant de charger quoi que ce soit :
grep -nE 'uuidv7\(|uuidv4\(|WITHOUT OVERLAPS|PERIOD ' schema.sql
grep -nE 'GENERATED ALWAYS AS \(' schema.sql | grep -v STORED     # colonnes virtuelles
grep -niE 'RETURNING +(old|new)\.|RETURNING +WITH *\(' schema.sql  # dans les fonctions et procédures
Dans notre schéma de test, cela a trouvé deux lignes :
56:    id uuid DEFAULT uuidv7() NOT NULL,
58:    price numeric GENERATED ALWAYS AS (((cents)::numeric / 100.0))
Notez la ligne 58 : pg_dump 18 écrit une colonne virtuelle sans mot-clé, donc chercher VIRTUAL ne la trouve pas. Tout GENERATED ALWAYS AS (…) qui n’est pas suivi de STORED est virtuel, y compris lorsqu’il est suivi de NOT NULL. Ajoutez STORED.
Qualifiez la fonction que vous avez remplacée. Un dump définit search_path à vide au début, et sur 18 uuidv7() est une fonction intégrée, donc le dump l’appelle sans qualification. Votre public.uuidv7() ne sera pas trouvée pendant le chargement :
ERROR: function uuidv7() does not existRéécrivez la valeur par défaut en public.uuidv7(). Créez ensuite vos fonctions de remplacement en premier, puis chargez tout en une seule transaction qui s’arrête à la première erreur :
psql "$TARGET_URL" -v ON_ERROR_STOP=1 --single-transaction \
  -f uuidv7.sql -f schema.sql -f data.sql
$TARGET_URL est votre chaîne de connexion Relyt One, qui se termine par ?sslmode=require. Avec ces deux modifications, notre base de données de test s’est chargée proprement sur 17. Les colonnes d’identité ont repris à la bonne valeur, la colonne générée a été recalculée au chargement, et les nouvelles lignes ont reçu des UUID de version 7 de la fonction de remplacement. Les valeurs des colonnes générées ne figurent pas du tout dans le dump des données, donc passer une colonne de virtuelle à stockée ne nécessite aucune modification des données.
-
SHOW server_version_numsur la cible ; sachez sur quelle version majeure vous êtes - Chargez avec psql 17.6+ ou 18.x et
-v ON_ERROR_STOP=1 - Cherchez avec
grepdans le dump du schémauuidv7(,uuidv4(,GENERATED ALWAYS ASsansSTORED,WITHOUT OVERLAPS,PERIOD, etRETURNING old./new.quelle que soit la casse - Créez les fonctions de remplacement avant le schéma, et qualifiez-les (
public.uuidv7()) - Remplacez
WITHOUT OVERLAPSpar une contrainte d’exclusion ; déplacez les clés étrangères temporelles dans un trigger - Cherchez aussi dans le code de l’application : les ORM et les générateurs de requêtes produisent des
RETURNING, et les fichiers de schéma du dépôt peuvent cibler 18 - Exécutez la suite de tests sur une branche avant d’y faire pointer la production
Cette dernière étape ne coûte pas grand-chose sur Relyt One : créez une branche, chargez-y les données, exécutez vos tests avec sa chaîne de connexion, et supprimez-la si quelque chose cloche.


