
¿Vienes de Postgres 18? Qué cambiar para Postgres 17
Relyt One corre PostgreSQL 17. Si tu esquema o tus hábitos vienen de Postgres 18, aquí está lo que falla en 17, qué escribir en su lugar y cómo cargar un dump tomado en 18, con cada fragmento ejecutado en ambas versiones.
En esta página

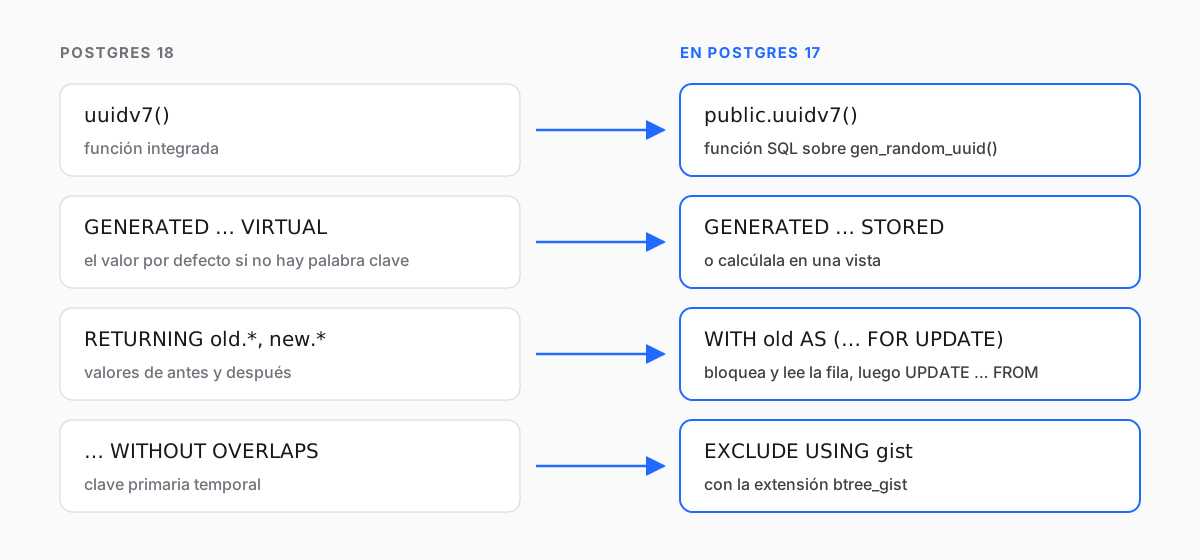
Relyt One corre PostgreSQL 17. Postgres 18 salió en septiembre de 2025, así que muchos proyectos nuevos, tutoriales y esquemas generados por IA ya dependen de funcionalidades exclusivas de 18: uuidv7(), columnas generadas virtuales, OLD y NEW en RETURNING, claves primarias temporales. En 17 cada una de ellas es un error. Este artículo enumera lo que falla, da para cada caso un reemplazo que funciona hoy en 17 y recorre la carga de un dump tomado en 18. Ejecutamos cada fragmento en PostgreSQL 17.5 y 18.6; las salidas que se muestran son las que obtuvimos.
Nada de esto es exótico. La mayoría de los esquemas no usa ninguna de estas funcionalidades, y los que sí las usan suelen usar una o dos. La idea es encontrarlas antes de que una migración falle a la mitad, no después.
SELECT version();
SHOW server_version_num;   -- 170005 significa 17.5; cualquier valor que empiece con 17 es Postgres 17
Si tu código necesita bifurcarse según la versión en tiempo de ejecución, compara server_version_num numéricamente (>= 180000), no la cadena de version().
Postgres 18 añadió uuidv7(), que genera UUID ordenados por tiempo. Son mejores claves primarias que los UUID aleatorios de versión 4 porque las filas nuevas caen al final del índice en lugar de dispersarse por todo él. En 17:
ERROR: function uuidv7() does not existPuedes generar el mismo formato en SQL. Un UUID de versión 7 es una marca de tiempo Unix de 48 bits en milisegundos seguida de bits aleatorios, con los bits de versión y de variante establecidos. gen_random_uuid() (integrada desde Postgres 13, sin necesidad de extensión) ya aporta los bits aleatorios y la variante, así que la función sobrescribe los primeros seis bytes con la marca de tiempo y cambia dos bits para pasar la versión de 4 a 7:
CREATE FUNCTION public.uuidv7() RETURNS uuid
LANGUAGE sql VOLATILE
AS $$
  -- Tiempo Unix de 48 bits en ms, luego versión 7 sobre los bits aleatorios de un UUID v4
  SELECT encode(
    set_bit(set_bit(
      overlay(uuid_send(gen_random_uuid())
              PLACING substring(int8send(floor(extract(epoch FROM clock_timestamp()) * 1000)::bigint) FROM 3)
              FROM 1 FOR 6),
      52, 1), 53, 1),
    'hex')::uuid;
$$;

CREATE TABLE events (
  id   uuid PRIMARY KEY DEFAULT public.uuidv7(),
  body text
);
En Postgres 15 y posteriores, por defecto solo el propietario de la base de datos puede crear objetos en public, así que ejecuta esto como el propietario (o coloca la función en un esquema que te pertenezca). Revisamos 10.000 valores generados: todos tienen versión 7 y la variante de RFC 9562, y la marca de tiempo incrustada coincidió con el reloj del servidor. Usa clock_timestamp() en lugar de now(), así que las filas insertadas más tarde en la misma transacción siguen obteniendo marcas de tiempo posteriores.
Hay una diferencia real. La función integrada de 18 también rellena una parte de submilisegundos, y en nuestra prueba 1.000 valores generados en una sola sentencia en 18 salieron en orden estrictamente creciente. La versión SQL ordena los valores entre milisegundos, pero no dentro de uno: los valores generados en el mismo milisegundo quedan en orden aleatorio. Para la localidad del índice eso no importa. Si tu código depende de que los ID de una misma sesión sean estrictamente crecientes, usa una secuencia para el orden.
Una trampa relacionada: uuid_extract_timestamp() existe en 17, pero ahí solo entiende UUID de versión 1 y devuelve NULL para la versión 7. Postgres 18 añadió el soporte para la versión 7. En 17, extrae la marca de tiempo tú mismo:
CREATE FUNCTION public.uuidv7_timestamp(u uuid) RETURNS timestamptz
LANGUAGE sql IMMUTABLE STRICT
AS $$
  SELECT to_timestamp(('x' || substr(replace(u::text, '-', ''), 1, 12))::bit(48)::bigint / 1000.0);
$$;

SELECT public.uuidv7_timestamp('019535d9-3df7-79fb-b466-fa907fa17f9e');
-- 2025-02-24 02:46:24.503+00, el mismo valor que devuelve uuid_extract_timestamp() en 18
A diferencia de la integrada, esta función auxiliar no comprueba la versión: si le das un UUID de versión 4, devuelve una hora sin sentido en lugar de NULL. Llámala solo con ID que sepas que son de versión 7.
En 18, una columna generada se calcula al leerse, salvo que indiques lo contrario. VIRTUAL es el nuevo valor por defecto y STORED es el comportamiento anterior. 17 solo tiene columnas generadas almacenadas y exige la palabra clave. Las dos sentencias siguientes fallan en 17:
CREATE TABLE product (price_cents int, price numeric GENERATED ALWAYS AS (price_cents / 100.0) VIRTUAL);
-- ERROR:  syntax error at or near "VIRTUAL"

CREATE TABLE product (price_cents int, price numeric GENERATED ALWAYS AS (price_cents / 100.0));
-- ERROR:  syntax error at or near ")"
La segunda importa más de lo que parece: en 18 es válida y significa virtual, así que los esquemas escritos para 18 a menudo no llevan ninguna palabra clave. Dos reemplazos:
-- Opción A: almacenarla. Misma columna, mismas consultas; cuesta disco y tiempo de escritura.
CREATE TABLE product (
  price_cents int,
  price       numeric GENERATED ALWAYS AS (price_cents / 100.0) STORED
);

-- Opción B: mantener la tabla ligera y calcular en una vista.
CREATE TABLE product_base (price_cents int);
CREATE VIEW product AS
  SELECT *, price_cents / 100.0 AS price FROM product_base;
Una vista simple como esta es actualizable automáticamente, así que INSERT INTO product (price_cents) VALUES (1999) sigue funcionando a través de ella. Lo probamos en 17. Elige A, salvo que la expresión sea grande o la tabla tenga mucha escritura.
18 permite que RETURNING haga referencia a la fila antes y después de un cambio:
UPDATE acct SET balance = balance - 30 WHERE id = 1
RETURNING old.balance AS before, new.balance AS after;
En 17 eso falla con missing FROM-clause entry for table "old". Para obtener los valores anteriores, lee y bloquea la fila en un CTE y luego únela en el UPDATE:
WITH old AS (
  SELECT id, balance FROM acct WHERE id = 1 FOR UPDATE
)
UPDATE acct a SET balance = a.balance - 30
FROM old
WHERE a.id = old.id
RETURNING old.balance AS before, a.balance AS after; before | after
--------+-------
100 | 70FOR UPDATE es lo que hace que esto sea correcto: bloquea la fila antes de que la actualización la lea, así que un cambio concurrente no puede colarse entre ambas y convertir before en una mentira. Sin él, con concurrencia, puedes devolver un valor "antes" que nunca fue el estado de la fila en el momento de tu actualización. Para DELETE, un simple RETURNING * ya devuelve la fila antigua. Para INSERT … ON CONFLICT DO UPDATE no hay un equivalente limpio en 17 para los valores antiguos. Si los necesitas, selecciónalos primero con FOR UPDATE o mantén un trigger de auditoría. Seleccionar primero no ayuda cuando la fila todavía no existe: no hay nada que bloquear, así que una inserción concurrente aún puede colarse en medio.
18 puede imponer "no hay dos filas para la misma sala con rangos de tiempo superpuestos" como clave primaria:
-- en 18 esto también necesita btree_gist, porque room es un int simple
CREATE TABLE booking (room int, during tstzrange, PRIMARY KEY (room, during WITHOUT OVERLAPS));
-- en 17: ERROR:  syntax error at or near "WITHOUT"
La garantía en sí existe desde hace años como restricción de exclusión. Combinar una columna de igualdad simple (room) con un rango en un mismo índice GiST requiere la extensión btree_gist, que está marcada como confiable, así que cualquier rol con CREATE sobre la base de datos (el propietario lo tiene) puede instalarla sin permisos de superusuario:
CREATE EXTENSION IF NOT EXISTS btree_gist;

CREATE TABLE booking (
  room   int       NOT NULL,
  during tstzrange NOT NULL CHECK (NOT isempty(during)),
  EXCLUDE USING gist (room WITH =, during WITH &&)
);

INSERT INTO booking VALUES (101, '[2026-11-10 09:00Z, 2026-11-10 10:00Z)');
INSERT INTO booking VALUES (101, '[2026-11-10 10:00Z, 2026-11-10 11:00Z)');  -- bien: se tocan, no se superponen
INSERT INTO booking VALUES (101, '[2026-11-10 09:30Z, 2026-11-10 10:30Z)');
-- ERROR:  conflicting key value violates exclusion constraint "booking_room_during_excl"
El CHECK importa: 18 rechaza los rangos vacíos en una clave WITHOUT OVERLAPS, pero un rango vacío nunca se superpone con nada, así que sin la comprobación la restricción de exclusión aceptaría cualquier cantidad de ellos. Comprueba que la extensión esté disponible en tu base de datos con SELECT * FROM pg_available_extensions WHERE name = 'btree_gist';. Confirmamos que viene incluida, en la versión 1.7, en la imagen de cómputo de Relyt One que probamos. Lo que 17 no puede hacer es la otra mitad de la funcionalidad: las claves foráneas temporales (FOREIGN KEY (…, PERIOD …)). No hay un equivalente declarativo. Imponlas en un trigger o en la aplicación, y pruébalas, porque es fácil equivocarse en los bordes de un rango.
Varias de las funcionalidades estrella de 18 cambian el rendimiento o la operación, no el SQL. Tu esquema y tus consultas no las mencionan, así que no hay nada que reescribir:
- La E/S asíncrona acelera los escaneos secuenciales, los bitmap heap scans y vacuum en 18. En 17 las mismas consultas funcionan y usan E/S síncrona.
- Skip scan permite que 18 use un índice B-tree multicolumna aunque la consulta no filtre por la columna inicial. Si una consulta en 17 filtra solo por la segunda columna de
(tenant_id, created_at), puede que no use ese índice. Revisa el plan conEXPLAINy, si importa, añade un índice que empiece por la columna filtrada. - La autenticación de cliente con OAuth es nueva en 18. A Relyt One te conectas con la contraseña del rol sobre TLS, usando la cadena de conexión de la consola con
sslmode=require. - La obsolescencia de las contraseñas MD5 en 18 no tiene efecto en los esquemas de 17.
La documentación de pg_dump es explícita: se espera que su salida se cargue en servidores más nuevos, y la carga en una versión mayor anterior "no está garantizada" y "puede requerir la edición manual del archivo de dump". Pasar de 18 a 17 es justo ese caso. Este es el procedimiento que usamos y lo que se rompió por el camino.
Usa un psql 17.6 o posterior para cargarlo. Los dumps del pg_dump actual empiezan con una línea \restrict, un metacomando de psql añadido en 17.6 por una corrección de seguridad (CVE-2025-8714) e incluido en todas las versiones de Postgres 18. psql 17.5 lo rechaza con invalid command \restrict. Con ON_ERROR_STOP=1 la carga se aborta justo ahí; sin él, psql continúa y se salta en silencio la protección que \restrict existe para dar. Usa un cliente 18.x o 17.6+: psql 18 se conecta sin problemas a un servidor 17.
Haz el dump del esquema y de los datos por separado, sin propietarios ni permisos, ya que los roles del destino serán distintos:
pg_dump "$SOURCE_URL" --schema-only --no-owner --no-privileges --quote-all-identifiers > schema.sql
pg_dump "$SOURCE_URL" --data-only   --no-owner --no-privileges --quote-all-identifiers > data.sql
--quote-all-identifiers es lo que recomienda la documentación de pg_dump para cargas entre versiones: evita sorpresas con palabras que son reservadas en una versión y no en la otra. Cargar los datos después del esquema completo significa que los índices, las claves foráneas y los triggers ya existen durante la carga. Eso es más lento que un único dump, y tus propios triggers se disparan por cada fila. Para una base de datos grande, divide en su lugar con --section=pre-data, data y post-data, y edita solo el archivo de pre-data.
Encuentra la sintaxis exclusiva de 18 antes de cargar nada:
grep -nE 'uuidv7\(|uuidv4\(|WITHOUT OVERLAPS|PERIOD ' schema.sql
grep -nE 'GENERATED ALWAYS AS \(' schema.sql | grep -v STORED     # columnas virtuales
grep -niE 'RETURNING +(old|new)\.|RETURNING +WITH *\(' schema.sql  # en funciones y procedimientos
En nuestro esquema de prueba esto encontró dos líneas:
56:    id uuid DEFAULT uuidv7() NOT NULL,
58:    price numeric GENERATED ALWAYS AS (((cents)::numeric / 100.0))
Fíjate en la línea 58: pg_dump 18 escribe una columna virtual sin palabra clave, así que buscar VIRTUAL no la encuentra. Cualquier GENERATED ALWAYS AS (…) que no vaya seguido de STORED es virtual, incluida una seguida de NOT NULL. Añade STORED.
Califica la función que reemplazaste. Un dump fija search_path en vacío al principio, y en 18 uuidv7() es integrada, así que el dump la llama sin calificar. Tu public.uuidv7() no se encontrará durante la carga:
ERROR: function uuidv7() does not existReescribe el valor por defecto como public.uuidv7(). Luego crea primero tus funciones de reemplazo y carga todo en una sola transacción que se detenga en el primer error:
psql "$TARGET_URL" -v ON_ERROR_STOP=1 --single-transaction \
  -f uuidv7.sql -f schema.sql -f data.sql
$TARGET_URL es tu cadena de conexión de Relyt One, terminada en ?sslmode=require. Con esas dos ediciones, nuestra base de datos de prueba se cargó sin errores en 17. Las columnas de identidad continuaron desde el valor correcto, la columna generada se recalculó al cargar y las filas nuevas obtuvieron UUID de versión 7 de la función de reemplazo. Los valores de las columnas generadas no están en el dump de datos, así que pasar una columna de virtual a almacenada no requiere cambios en los datos.
-
SHOW server_version_numen el destino; ten claro en qué versión mayor estás - Carga con psql 17.6+ o 18.x y
-v ON_ERROR_STOP=1 - Busca con
grepen el dump del esquemauuidv7(,uuidv4(,GENERATED ALWAYS ASsinSTORED,WITHOUT OVERLAPS,PERIODyRETURNING old./new.en mayúsculas o minúsculas - Crea las funciones de reemplazo antes del esquema y califícalas (
public.uuidv7()) - Reemplaza
WITHOUT OVERLAPSpor una restricción de exclusión; lleva las claves foráneas temporales a un trigger - Revisa también el código de la aplicación: los ORM y los constructores de consultas generan
RETURNING, y los archivos de esquema del repositorio pueden estar pensados para 18 - Ejecuta la suite de pruebas contra una rama antes de apuntar producción hacia ella
Ese último paso es barato en Relyt One: crea una rama, carga en ella, ejecuta tus pruebas contra su cadena de conexión y deséchala si algo no cuadra.


