
Postgres como cola de trabajos: FOR UPDATE SKIP LOCKED, bien hecho
Cómo construir una cola de trabajos en segundo plano en PostgreSQL 17 con SELECT ... FOR UPDATE SKIP LOCKED: por qué el ingenuo SELECT-y-luego-UPDATE toma el mismo trabajo dos veces, por qué FOR UPDATE por sí solo hace esperar a los workers, leases y reintentos, LISTEN/NOTIFY, vacuum y lo que los workers que hacen polling le hacen a un cómputo serverless. Cada sentencia reproducida en Postgres 17.11.
En esta página

No necesitas Redis ni un broker de mensajes para ejecutar trabajos en segundo plano. Una tabla de Postgres y FOR UPDATE SKIP LOCKED entregan cada trabajo a un solo worker a la vez, sobreviven a las caídas y mantienen el trabajo en la misma transacción que los datos a los que pertenece. El problema es que la primera versión obvia está mal: en nuestra prueba, ocho workers que ejecutaban un simple "selecciona el trabajo más antiguo y luego actualízalo" tomaron las mismas filas hasta ocho veces y terminaron unos 2.100 de 10.000 trabajos. Este artículo reproduce ese bug, construye la cola que lo corrige (tomar, completar, reintentar, recuperar) y cubre las partes que muerden más tarde: transacciones abiertas durante el trabajo, LISTEN/NOTIFY, vacuum y lo que los workers que hacen polling le hacen a un cómputo que se suspende cuando está inactivo. Todas las sentencias y todas las salidas de abajo vienen de un PostgreSQL 17.11 local, la versión mayor que ejecuta Relyt One.
| Síntoma | Causa | Solución |
|---|---|---|
| Dos workers ejecutan el mismo trabajo | UPDATE ... WHERE id = (SELECT ... LIMIT 1) sin bloqueos de fila | Bloquea las filas que eliges: FOR UPDATE SKIP LOCKED |
| Los workers se turnan en lugar de trabajar en paralelo | FOR UPDATE sin SKIP LOCKED: cada worker espera al que tiene delante | Añade SKIP LOCKED |
| Vacuum deja de limpiar y la tabla crece | Un worker mantiene su transacción abierta mientras se ejecuta el trabajo | Toma el trabajo en una transacción corta y registra un lease |
Un trabajo se queda en running para siempre tras una caída | Nada lo recupera | Haz que el lease caduque y devuelve el trabajo a la cola |
| Un worker rezagado marca como terminado un trabajo ya recuperado | Al completar no se comprueba quién es el dueño del trabajo | Protege la finalización con el número de intento |
| El cómputo serverless nunca se suspende | Un worker hace polling cada pocos segundos | Elige a propósito una estrategia de polling (mira la última sección) |
Una tabla, una fila por trabajo. El índice parcial cubre solo las filas que buscan los workers, así que sigue siendo pequeño aunque la tabla guarde un largo historial de trabajos terminados.
CREATE TABLE jobs (
  id           bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  queue        text        NOT NULL DEFAULT 'default',
  payload      jsonb       NOT NULL,
  status       text        NOT NULL DEFAULT 'queued'
               CHECK (status IN ('queued', 'running', 'done', 'failed')),
  run_at       timestamptz NOT NULL DEFAULT now(),
  attempts     int         NOT NULL DEFAULT 0,
  max_attempts int         NOT NULL DEFAULT 5,
  locked_until timestamptz,
  last_error   text,
  created_at   timestamptz NOT NULL DEFAULT now()
);

CREATE INDEX jobs_ready_idx ON jobs (queue, run_at) WHERE status = 'queued';

INSERT INTO jobs (payload)
SELECT jsonb_build_object('email_id', g) FROM generate_series(1, 10) AS g;
run_at sirve también como calendario de reintentos: un trabajo está listo cuando está queued y run_at <= now(). locked_until es el lease, al que llegaremos enseguida.
Esta es la versión que casi todo el mundo escribe primero. Parece atómica porque es una sola sentencia:
UPDATE jobs
SET status = 'running', attempts = attempts + 1
WHERE id = (
  SELECT id FROM jobs
  WHERE status = 'queued'
  ORDER BY run_at
  LIMIT 1
)
RETURNING id, attempts;
Ejecútala en dos sesiones a la vez. La sesión A la ejecuta dentro de una transacción y sigue trabajando cuando la sesión B ejecuta la misma sentencia:
-- session A (inside BEGIN, not committed yet)
 id | attempts
----+----------
  1 |        1

-- session B, returns after A commits
 id | attempts
----+----------
  1 |        2
Las dos sesiones tomaron el trabajo 1, y el trabajo 2 sigue queued. Este es el motivo. La subconsulta se ejecuta una sola vez, ve el trabajo 1 como el trabajo queued más antiguo y le pasa al UPDATE exterior el valor id = 1. Después, B tiene que esperar al bloqueo de fila de A. En READ COMMITTED, una vez que A hace commit, Postgres vuelve a evaluar la cláusula WHERE sobre la nueva versión de la fila. La única condición que queda es id = 1, que sigue cumpliéndose, así que B actualiza el trabajo que A ya había tomado.
Dos sesiones en un laboratorio son una cosa, así que ejecutamos ocho workers con pgbench contra 10.000 trabajos en cola, 1.250 tomas por worker:
pgbench -n -c 8 -j 8 -t 1250 -f naive.sql postgresnaive.sql es la sentencia de arriba con status = 'done', así que cada toma es también una finalización. Después:
 status | count | max_attempts
--------+-------+--------------
 done   |  2100 |            8
 queued |  7900 |            0
10.000 tomas terminaron unos 2.100 trabajos (entre 2.068 y 2.137 en ocho ejecuciones en dos máquinas), y algunos trabajos los tomaron los ocho workers. En un sistema real, eso son ocho copias del mismo correo.
Bloquear las filas que seleccionas corrige la doble toma. Pon la elección en un CTE con FOR UPDATE y actualiza a través de él:
WITH next AS (
  SELECT id FROM jobs
  WHERE queue = 'default' AND status = 'queued' AND run_at <= now()
  ORDER BY run_at
  LIMIT 1
  FOR UPDATE
)
UPDATE jobs j
SET status = 'running', attempts = j.attempts + 1
FROM next
WHERE j.id = next.id
RETURNING j.id;
Ahora la sesión B se bloquea en el trabajo 1. Cuando A hace commit, Postgres vuelve a comprobar el trabajo 1, ve que ya no cumple status = 'queued', lo descarta y pasa al trabajo 2. Es correcto, pero fíjate en el tiempo de B:
 id
----
  2
(1 row)

UPDATE 1
Time: 1858.126 ms (00:01.858)
B esperó todo el tiempo que A mantuvo abierta su transacción. Con más workers, se ponen en fila detrás de la misma primera fila y trabajan de uno en uno.
Añade dos palabras. De la referencia de SELECT: "With SKIP LOCKED, any selected rows that cannot be immediately locked are skipped." (Con SKIP LOCKED, se omite cualquier fila seleccionada que no se pueda bloquear de inmediato). La documentación también dice para qué sirve: da una vista inconsistente de los datos, así que no es para trabajo de propósito general, "but can be used to avoid lock contention with multiple consumers accessing a queue-like table." (pero se puede usar para evitar la contención de bloqueos cuando varios consumidores acceden a una tabla tipo cola).
Con A todavía reteniendo el trabajo 1, B obtiene el trabajo 2 de inmediato:
 id
----
  2
(1 row)

UPDATE 1
Time: 2.512 ms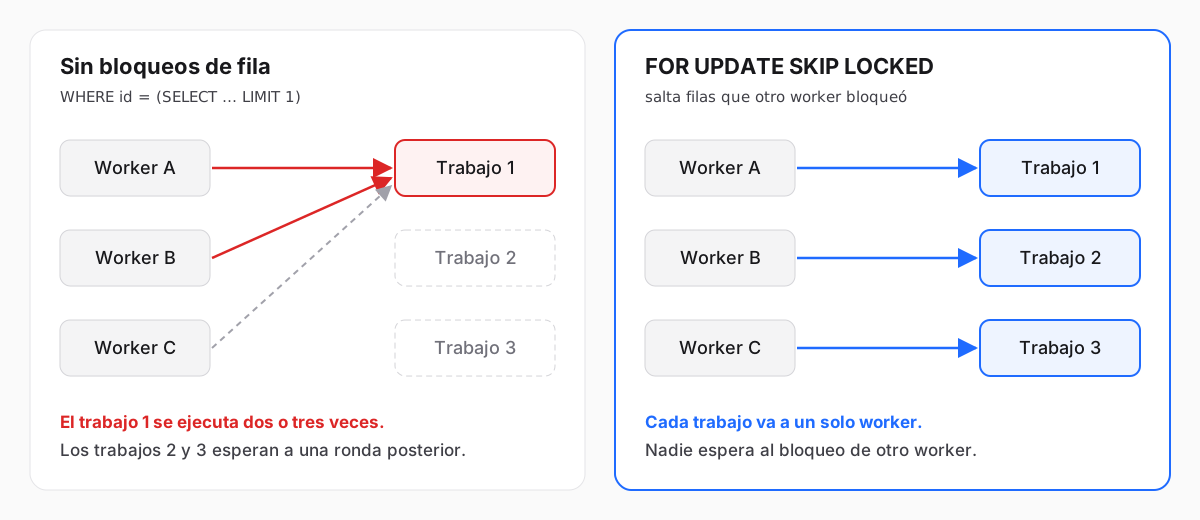
La misma ejecución de pgbench con SKIP LOCKED en lugar de la sentencia ingenua:
 status | count | max_attempts
--------+-------+--------------
 done   | 10000 |            1
Todos los trabajos terminados, cada uno exactamente una vez.
Esta es la toma que usaremos de aquí en adelante. Toma hasta 10 trabajos por ida y vuelta, lo que importa cuando cada trabajo es rápido, y escribe un lease:
WITH next AS (
  SELECT id FROM jobs
  WHERE queue = 'default' AND status = 'queued' AND run_at <= now()
  ORDER BY run_at
  LIMIT 10
  FOR UPDATE SKIP LOCKED
)
UPDATE jobs j
SET status       = 'running',
    attempts     = j.attempts + 1,
    locked_until = now() + interval '5 minutes'
FROM next
WHERE j.id = next.id
RETURNING j.id, j.payload, j.attempts;
En una tabla con unos pocos miles de filas, EXPLAIN (COSTS OFF) muestra la forma que quieres: Limit sobre LockRows sobre un index scan en jobs_ready_idx, así que un worker solo toca filas listas y se detiene después de 10.
 Update on jobs j
   CTE next
     ->  Limit
           ->  LockRows
                 ->  Index Scan using jobs_ready_idx on jobs
                       Index Cond: ((queue = 'default'::text) AND (run_at <= now()))
                       Filter: (status = 'queued'::text)
   ->  Nested Loop
         ->  CTE Scan on next
         ->  Index Scan using jobs_pkey on jobs j
Index Cond: (id = next.id)Hay dos formas de usar esa toma:
- Bloquear mientras trabajas.
BEGIN, tomar, hacer el trabajo, marcarlo como terminado,COMMIT. Una caída hace rollback y el trabajo vuelve a quedar libre, lo cual resulta atractivo. - Lease. Tomar y hacer
COMMITenseguida constatus = 'running'ylocked_until. Hacer el trabajo fuera de cualquier transacción. Marcarlo como terminado en una segunda transacción corta.
La primera está bien para trabajos que tardan milisegundos. Para cualquier cosa que llame a una API, envíe correo o genere un archivo, usa el lease. Una transacción que ha escrito algo (una toma lo ha hecho) y luego se queda esperando está idle in transaction, y mientras sigue abierta, vacuum no puede eliminar las versiones de fila que quedaron muertas después de que empezara, en ninguna tabla de esa base de datos. Una transacción REPEATABLE READ que se deja abierta hace lo mismo aunque solo haya leído.
Mantuvimos una toma abierta de esa forma, dejamos que otros workers procesaran 2.000 trabajos y ejecutamos VACUUM (VERBOSE) jobs:
tuples: 0 removed, 11992 remain, 2000 are dead but not yet removableDespués de que la transacción abierta hiciera commit, el mismo comando:
tuples: 2001 removed, 8542 remain, 0 are dead but not yet removableUna tabla de cola es todo actualizaciones y borrados, así que es la primera tabla que se hincha cuando se frena a vacuum. Una transacción abierta además retiene una conexión al servidor, y si estás detrás de un pooler en modo transacción, esa conexión queda fuera del pool hasta que haces commit. Las transacciones cortas evitan ambas cosas.
Con leases, todo el ciclo de vida de un trabajo son cuatro sentencias cortas. Las que un worker ejecuta después de la toma comprueban status = 'running' y attempts, el valor que devolvió la toma, así que un worker solo puede modificar un trabajo que todavía le pertenece.
Completar. El worker devuelve el id y el número de intento que obtuvo de la toma:
UPDATE jobs
SET status = 'done', locked_until = NULL
WHERE id = 1 AND status = 'running' AND attempts = 1;
Fallar y reintentar con backoff. 20 segundos después del primer fallo, 40 después del segundo, duplicándose hasta un tope de una hora, y failed definitivamente tras max_attempts. Con el valor predeterminado de 5 intentos, la espera más larga es de 160 segundos; el tope solo importa si subes max_attempts.
UPDATE jobs
SET status       = CASE WHEN attempts >= max_attempts THEN 'failed' ELSE 'queued' END,
    run_at       = now() + least(interval '1 hour', interval '10 seconds' * 2 ^ attempts),
    locked_until = NULL,
    last_error   = 'SMTP 451: try again later'
WHERE id = 2 AND status = 'running' AND attempts = 1
RETURNING id, status, attempts, run_at - now() AS retry_in; id | status | attempts | retry_in
----+--------+----------+----------
2 | queued | 1 | 00:00:20Recuperar leases caducados. Si un worker muere a mitad de un trabajo, su lease se agota y cualquier worker (o un cron job) devuelve el trabajo a la cola. Un trabajo que mata a su worker cada vez volvería para siempre, así que el reaper también respeta max_attempts:
UPDATE jobs
SET status       = CASE WHEN attempts >= max_attempts THEN 'failed' ELSE 'queued' END,
    locked_until = NULL,
    last_error   = coalesce(last_error, 'lease expired')
WHERE status = 'running' AND locked_until < now()
RETURNING id, status, attempts;
Por qué importa la comprobación del intento. Supón que el worker del trabajo 3 no estaba muerto, solo iba lento. Su lease caducó, el reaper devolvió el trabajo a la cola y otro worker lo tomó, así que ahora attempts vale 2. Cuando el worker lento por fin termina y ejecuta su finalización con attempts = 1, no pasa nada:
UPDATE 0El trabajo se queda con su dueño actual. Sin la comprobación, el worker lento marcaría el trabajo como terminado mientras el segundo worker todavía lo está ejecutando. Tu trabajo debería seguir siendo idempotente, porque los efectos secundarios del worker lento ya ocurrieron. La comprobación solo mantiene honesto el estado del trabajo.
Elige un lease más largo que tu trabajo normal más lento, o haz que los trabajos largos extiendan su propio lease sobre la marcha, y que se detengan si la extensión no actualiza ninguna fila, porque el trabajo ya no es suyo:
UPDATE jobs
SET locked_until = now() + interval '5 minutes'
WHERE id = $1 AND status = 'running' AND attempts = $2;Los workers necesitan enterarse de que hay trabajo. La forma más sencilla es ejecutar la toma en un bucle y dormir cuando no devuelve nada. La alternativa es que Postgres les avise:
CREATE FUNCTION jobs_notify() RETURNS trigger
LANGUAGE plpgsql AS $$
BEGIN
  PERFORM pg_notify('jobs', NEW.queue);
  RETURN NULL;
END;
$$;

CREATE TRIGGER jobs_notify
AFTER INSERT ON jobs
FOR EACH ROW EXECUTE FUNCTION jobs_notify();
Un worker ejecuta LISTEN jobs y toma trabajos cuando llega una notificación. Tres propiedades de la referencia de NOTIFY determinan cómo lo usas:
- La entrega ocurre en el commit. Dentro de una transacción, las notificaciones "are not delivered until and unless the transaction is committed." (no se entregan hasta que la transacción haga commit, y solo si lo hace). En nuestra prueba, el productor insertó un trabajo a las 13:08:30 e hizo commit a las 13:08:33. La comprobación del listener a las 13:08:31 no vio nada, y la notificación apareció en su siguiente comprobación. Eso es lo que quieres, porque un worker despertado antes de tiempo encontraría un trabajo que todavía no puede ver.
- Las notificaciones no son una cola. Solo las reciben las sesiones que están escuchando en ese momento, y las notificaciones idénticas dentro de una transacción se funden en una. Trata una notificación como "ve a mirar", nunca como el trabajo en sí, y mantén un polling más lento como respaldo para lo que te pierdas mientras te reconectas.
- Los payloads son pequeños. En la configuración predeterminada, el payload debe ocupar menos de 8000 bytes. Envía el nombre de la cola o un id, no el trabajo.
Una más: LISTEN pertenece a una conexión al servidor, así que necesita una conexión directa, no una a través de un pooler en modo transacción. Explicamos por qué en Qué se rompe detrás del pooling por transacción de PgBouncer y cómo arreglar cada caso. Los productores y las consultas de toma pueden usar la conexión del pooler.
En Relyt One, un cómputo que lleva unos diez minutos sin nada que hacer se suspende, y la siguiente conexión lo reanuda. Para una cola, lo que importa es qué cuenta como "algo que hacer". El monitor de actividad del cómputo revisa las sesiones de cliente cada medio segundo:
- cualquier sesión que no esté
idle(ejecutando una consulta, oidle in transaction) cuenta como actividad en este momento; - una sesión
idlecuenta como actividad a partir de su último cambio de estado, es decir, de cuando terminó su última consulta; - un worker de autovacuum en ejecución, o una conexión de replicación lógica activa, también mantiene despierto el cómputo.
Así que un worker que hace polling cada segundo, o cada cinco minutos, mantiene despierto el cómputo todo el día, aunque la cola esté vacía toda la noche. Un worker que mantiene una transacción abierta mientras trabaja lo mantiene despierto durante todo el trabajo. Una conexión inactiva por sí sola no lo hace, porque su último cambio de estado se va quedando cada vez más atrás. De ahí se siguen tres cosas. Una suspensión cierra todas las conexiones, incluida la de LISTEN, y un worker que se reconecta de inmediato reanuda el cómputo. Las consultas de health check de un driver o de un pool cuentan como actividad. Y un polling de respaldo que se ejecute con más frecuencia que cada diez minutos mantiene el cómputo encendido.
Eso te deja tres opciones honestas:
- Los trabajos deben empezar en segundos. Acepta un cómputo siempre encendido mientras se ejecutan los workers. Ese es el coste de la baja latencia en cualquier plataforma. Haz polling con un intervalo que puedas asumir, o usa
LISTENcon un polling de respaldo. - Los trabajos pueden esperar un rato. No ejecutes workers todo el día. Arráncalos con una programación que deje huecos más largos que el tiempo de inactividad, haz que vacíen la cola con la toma por lotes y que terminen. Entre ejecuciones, el cómputo puede suspenderse, y la primera conexión de la siguiente ejecución lo reanuda.
- Los trabajos vienen de tu propia aplicación. Haz que la solicitud que encola un trabajo también lance un worker (una función serverless, una tarea en el ejecutor de trabajos de tu plataforma). La base de datos sigue siendo la fuente de verdad del estado, los reintentos y los leases, y nada tiene que hacer polling.
Las ramas también ayudan aquí. Cada rama tiene su propio cómputo, así que puedes apuntar una flota de workers de prueba a una rama con una copia de los datos de producción, machacar la consulta de toma y dejar en paz el cómputo de producción.
Los trabajos terminados no tienen por qué quedarse en la tabla activa. Bórralos por lotes, o muévelos a una tabla de archivo, de forma programada:
DELETE FROM jobs
WHERE id IN (
  SELECT id FROM jobs
  WHERE status = 'done' AND created_at < now() - interval '7 days'
  LIMIT 10000
);
Cada toma, finalización y reintento escribe una nueva versión de fila, así que la tabla produce tuplas muertas de forma constante. Vigila n_dead_tup y last_autovacuum en pg_stat_user_tables para jobs, y mantén las transacciones cortas para que vacuum pueda eliminar de verdad lo que encuentra.
Una tabla de trabajos encaja bien cuando los trabajos están relacionados con filas de la misma base de datos, el rendimiento está en el orden de un UPDATE por trabajo y quieres que encolar forme parte de la misma transacción que el cambio de datos. Esto último es algo que un broker externo no puede darte sin maquinaria adicional. Encaja mal para el fan-out a muchos consumidores independientes, para conservar un stream que reproducir más tarde, o para volúmenes en los que la propia rotación de actualizaciones se convierte en el cuello de botella. Para eso, usa un broker o un log.
- Toma con un CTE y
FOR UPDATE SKIP LOCKED, nunca conWHERE id = (SELECT ... LIMIT 1)sin bloqueos - Usa un índice parcial sobre la condición de listo
- Toma y haz commit enseguida; registra
locked_until; haz el trabajo fuera de la transacción - Completa, marca el fallo y extiende con
WHERE id = $1 AND status = 'running' AND attempts = $2, y comprueba el número de filas - Ejecuta un reaper para los leases caducados; limita los reintentos con
max_attempts - Usa
LISTENen una conexión directa, trata las notificaciones como pistas, mantén un polling de respaldo - Borra o archiva los trabajos terminados; vigila
n_dead_tup - Decide cómo esperan los workers, sabiendo qué mantiene despierto a un cómputo serverless
Cada sentencia de este artículo es SQL simple de PostgreSQL 17, sin extensiones. Crea un proyecto gratuito de Relyt One, abre una rama y apunta dos sesiones de psql a ella para ver cómo SKIP LOCKED les entrega filas distintas.


