
Qué se rompe detrás del pooling por transacción de PgBouncer y cómo arreglar cada caso
Por qué aparece 'prepared statement already exists', por qué la configuración se filtra entre solicitudes y por qué los advisory locks no bloquean nada detrás de un pooler por transacción, reproducido en PgBouncer 1.24 y PostgreSQL 17, con la solución de cada caso y una regla para saber cuándo usar la conexión directa.
En esta página

Pon PgBouncer en modo transacción delante de Postgres y miles de clientes de vida corta podrán compartir unas pocas docenas de conexiones de servidor. El precio es que "mi conexión" deja de significar algo entre transacciones. De ahí vienen errores como prepared statement "s0" already exists, junto con un SET que aparece en la solicitud de otro y un advisory lock que dos workers tienen a la vez. Este artículo reproduce cada uno de estos casos en un PgBouncer 1.24.1 y un PostgreSQL 17.11 locales, configurados como funciona la cadena de conexión con pooling de Relyt One (modo transacción, Postgres 17), muestra la solución de cada uno y termina con una regla para saber cuándo saltarte el pooler. Todos los comandos y todas las salidas de abajo se ejecutaron en esa configuración local.
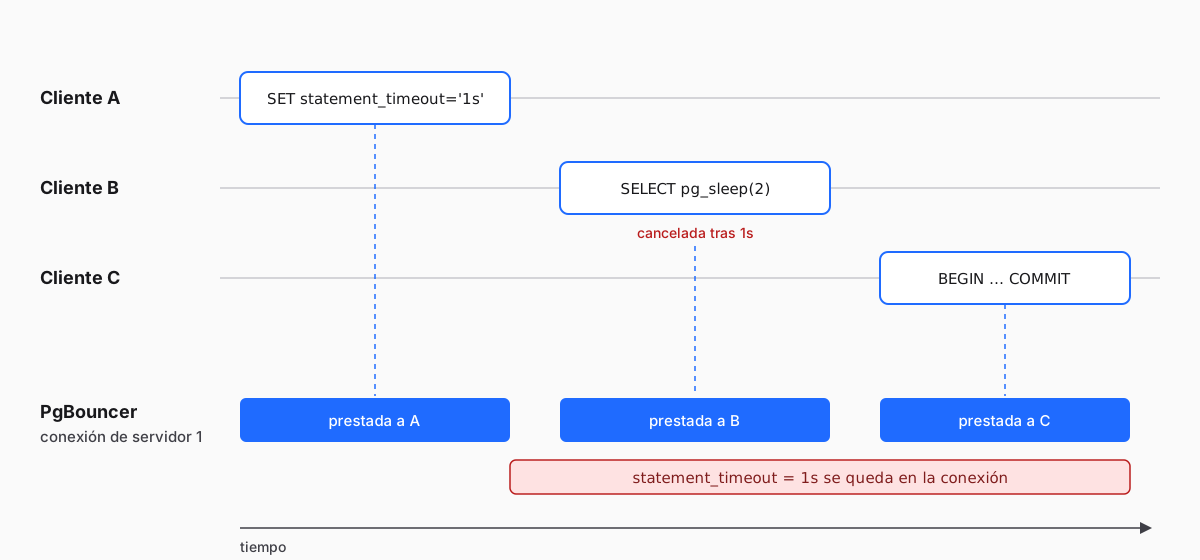
En modo transacción, PgBouncer le presta a un cliente una conexión de servidor durante una transacción y la recupera en el COMMIT o el ROLLBACK. Una sentencia fuera de una transacción explícita es una transacción por sí misma. Todo lo que vive en la conexión de servidor más de una transacción o se filtra al siguiente cliente o falta en la siguiente transacción. Estas son las víctimas, según la tabla de funciones de PgBouncer, su referencia de configuración y nuestro laboratorio:
| Usas | Qué sale mal | Solución |
|---|---|---|
SET statement_timeout, SET search_path, … | La configuración se queda en la conexión de servidor y se aplica al cliente que la reciba después | SET LOCAL o set_config(…, true) dentro de una transacción; ALTER ROLE … SET para los valores por defecto |
PREPARE / EXECUTE en SQL | Errores already exists / does not exist | No uses prepared statements a nivel de SQL a través del pooler |
| Los prepared statements con nombre de tu driver | Los mismos errores, desde el driver | Desactívalos en el driver o usa un pooler con max_prepared_statements configurado |
pg_advisory_lock() | Dos clientes pueden "tener" el mismo bloqueo a la vez | pg_advisory_xact_lock() dentro de una transacción |
options=-c … en la cadena de conexión | Conexión rechazada | ALTER ROLE … SET, o SET LOCAL por transacción |
LISTEN, cursores WITH HOLD, tablas temporales que sobreviven a una transacción | Resultados poco fiables o incorrectos | Usa la conexión directa |
El resto del artículo muestra cada fila en acción.
Dos detalles de la referencia de configuración de PgBouncer explican casi todo lo que sigue:
- Nada se reinicia entre clientes.
server_reset_query(por defectoDISCARD ALL) "no se usa" en el pooling por transacción. Lo que una transacción deje en la conexión de servidor lo hereda el siguiente cliente. - Algunas configuraciones se rastrean y el resto no. PgBouncer recuerda los valores de cada cliente para una lista corta de parámetros que Postgres informa al cliente (en 1.24:
client_encoding,DateStyle,IntervalStyle,TimeZone,standard_conforming_stringsyapplication_name) y los restaura cuando le entrega una conexión de servidor a ese cliente. La tabla de funciones marca cualquier otroSETcomo incompatible con el pooling por transacción: el cambio se queda en la conexión de servidor, para el siguiente cliente.
Todo lo de abajo se ejecuta contra un Postgres 17.11 y un PgBouncer 1.24.1 locales en Docker. La imagen de PgBouncer es edoburu/pgbouncer, mantenida por la comunidad. La configuración del pooler usa el modo transacción y deja desactivado el rastreo de prepared statements, como el pooler de Relyt One, pero fija el pool en una conexión de servidor. Con una sola conexión de servidor, todos los clientes caen en la misma, así que cada fallo ocurre siempre en lugar de de vez en cuando. En producción, con docenas de conexiones de servidor en el pool, los mismos fallos son intermitentes, y precisamente por eso cuesta tanto depurarlos.
; pgbouncer.ini
[databases]
* = host=pg port=5432

[pgbouncer]
listen_addr = 0.0.0.0
listen_port = 6432
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt
pool_mode = transaction
default_pool_size = 1
max_prepared_statements = 0
ignore_startup_parameters = extra_float_digitsecho '"app" "secret"' > userlist.txt
docker network create pgblab
docker run -d --name pg --network pgblab \
-e POSTGRES_USER=app -e POSTGRES_PASSWORD=secret -e POSTGRES_DB=app \
postgres:17.11-alpine
docker run -d --name pgbouncer --network pgblab -p 6432:6432 \
-v "$PWD/pgbouncer.ini:/etc/pgbouncer/pgbouncer.ini:ro" \
-v "$PWD/userlist.txt:/etc/pgbouncer/userlist.txt:ro" \
edoburu/pgbouncer:v1.24.1-p1
export PGPASSWORD=secretCada psql -c de abajo es una conexión de cliente distinta a PgBouncer, como lo serían solicitudes distintas de una aplicación web o invocaciones serverless distintas. Pega primero esta función auxiliar en tu shell:
pooled() { psql -X -h localhost -p 6432 -U app app "$@"; }El cliente A fija un statement timeout de un segundo, como podría hacerlo una aplicación al inicio de una solicitud. El cliente B es otra persona:
pooled -c "SET statement_timeout = '1s';"
pooled -c "SHOW statement_timeout;" -c "SELECT pg_sleep(2);"SET
statement_timeout
-------------------
1s
(1 row)
ERROR: canceling statement due to statement timeoutEl cliente B nunca fijó un timeout y aun así su consulta de dos segundos se canceló. El SET se ejecutó en una transacción propia, la conexión de servidor volvió al pool todavía con statement_timeout = 1s y B recibió esa conexión. Con un pool más grande también ocurre lo contrario: la siguiente sentencia del cliente A cae en otra conexión de servidor, donde el timeout nunca se fijó. En producción ves ambas cosas: una configuración que a veces no se aplica, y timeouts o un search_path incorrecto en solicitudes que nunca los pidieron.
Los parámetros rastreados se comportan de otra forma. El mismo experimento con SET TimeZone = 'Asia/Tokyo' seguido de SHOW TimeZone desde un segundo cliente imprime UTC, porque PgBouncer restaura el valor propio de cada cliente. search_path no está en esa lista y se filtra igual que statement_timeout:
pooled -c "SET search_path = app_private, public;"
pooled -Atc "SHOW search_path;"SET
app_private, publicLa solución: limita la configuración a una transacción. SET LOCAL dura hasta el final de la transacción actual, así que se aplica a todas sus sentencias y desaparece antes de que la conexión de servidor vuelva al pool:
pooled -c "BEGIN; SET LOCAL statement_timeout = '1s'; SHOW statement_timeout; COMMIT;"
pooled -Atc "SHOW statement_timeout;"BEGIN
SET
statement_timeout
-------------------
1s
(1 row)
COMMIT
0(Si lo estás siguiendo, ejecuta antes pooled -c "RESET statement_timeout;" -c "RESET search_path;" para limpiar lo que dejaron las filtraciones de arriba.) Desde el código de la aplicación, set_config(name, value, true) hace lo mismo que SET LOCAL y acepta parámetros, por lo que es la forma habitual de pasar un ID de usuario a las políticas de row-level security. Nuestra guía de autenticación gestionada usa exactamente ese patrón, y funciona detrás del pooler por la misma razón.
Para una configuración que deba tener toda conexión, asígnala al rol:
ALTER ROLE app SET statement_timeout = '5s';Postgres aplica la configuración del rol cuando se inicia una conexión de servidor. Las conexiones de servidor que PgBouncer ya tiene abiertas conservan su valor anterior; en nuestro laboratorio, SHOW statement_timeout a través del pooler todavía imprimía 0 justo después del ALTER ROLE, y 5s una vez que PgBouncer abrió nuevas conexiones de servidor.
Los prepared statements a nivel de SQL pertenecen a una conexión de servidor. Dos clientes que preparan el mismo nombre acaban tarde o temprano en la misma conexión de servidor:
pooled -c "PREPARE get_one AS SELECT 1;"
pooled -c "PREPARE get_one AS SELECT 1;"PREPARE
ERROR: prepared statement "get_one" already existsPgBouncer nunca rastrea el PREPARE a nivel de SQL: la referencia de configuración dice que reenvía PREPARE, EXECUTE y DEALLOCATE a Postgres, sea cual sea la configuración. A través de un pooler por transacción, no los uses. (pooled -c "DEALLOCATE ALL;" limpia el laboratorio.)
La mayoría de la gente se topa con este error a través de su driver. Muchos drivers usan prepared statements a nivel de protocolo, por defecto o en cuanto una consulta se repite: envían la consulta una vez con un nombre y después la ejecutan por nombre. Este es node-postgres (pg 8.23) ejecutando una consulta con nombre desde dos clientes:
// named.js
const { Client } = require('pg');

async function main() {
  const url = process.env.DATABASE_URL;
  const a = new Client({ connectionString: url });
  const b = new Client({ connectionString: url });
  await a.connect();
  await b.connect();
  const query = { name: 'get-account', text: 'SELECT $1::int AS id' };
  try {
    console.log('a:', (await a.query({ ...query, values: [1] })).rows);
    console.log('b:', (await b.query({ ...query, values: [2] })).rows);
  } catch (err) {
    console.log('error:', err.message);
  } finally {
    await a.end();
    await b.end();
  }
}

main();npm install pg@8.23.1
DATABASE_URL=postgres://app:secret@localhost:6432/app node named.jsa: [ { id: 1 } ]
error: prepared statement "get-account" already existsEl caso inverso necesita un pool de dos conexiones de servidor. El cliente A ejecuta la consulta con nombre, otro cliente abre una transacción y toma la conexión de servidor que A acaba de usar, y A vuelve a ejecutar la consulta. El driver recuerda que ya preparó get-account, envía solo el mensaje de "ejecútala" y cae en la otra conexión de servidor: prepared statement "get-account" does not exist. Reprodujimos ambos errores en el laboratorio.
PgBouncer 1.21 añadió una solución para el caso a nivel de protocolo: con max_prepared_statements mayor que cero, rastrea los statements que prepara cada cliente y los prepara en la conexión de servidor que reciba el cliente. Repetimos ambos experimentos con max_prepared_statements = 200 y los dos errores desaparecieron, mientras que el PREPARE a nivel de SQL de arriba siguió fallando.
En la cadena de conexión con pooling de Relyt One, ese rastreo está desactivado (max_prepared_statements = 0), así que desactiva los prepared statements con nombre en tu driver cuando te conectes a través del pooler:
| Driver | A través del pooler |
|---|---|
node-postgres (pg) | No pases name en la configuración de las consultas. Las consultas parametrizadas normales (client.query(text, values)) usan un statement sin nombre y funcionan bien; lo comprobamos en el laboratorio |
| psycopg 3 | Conéctate con prepare_threshold=None, que desactiva los prepared statements |
| asyncpg | Pasa statement_cache_size=0 a connect() o create_pool(), como recomienda su FAQ para PgBouncer |
| Prisma | Añade pgbouncer=true a la URL con pooling y ejecuta las migraciones sobre una URL directa. La guía de Prisma omite el flag para PgBouncer 1.21 y posteriores, pero eso supone que max_prepared_statements es mayor que cero, y aquí no lo es (consulta la guía de PgBouncer de Prisma) |
Renuncias al tiempo de planificación que se ahorra al preparar un statement una sola vez. Para las consultas cortas que ejecuta una solicitud web, ese costo suele ser pequeño comparado con el viaje de ida y vuelta por la red; si dependes de los prepared statements, usa la conexión directa.
Los advisory locks a nivel de sesión son una forma común de garantizar que solo un worker ejecute un trabajo. Pertenecen a la conexión de servidor y son reentrantes: la sesión que tiene un bloqueo puede volver a tomarlo. Detrás de un pooler por transacción, eso se convierte en esto:
pooled -c "SELECT pg_advisory_lock(42);"
pooled -c "SELECT pg_try_advisory_lock(42) AS got_it;" pg_advisory_lock
------------------
(1 row)
got_it
--------
t
(1 row)El worker A tomó el bloqueo 42. El worker B pidió el mismo bloqueo y Postgres dijo que sí, porque ambas solicitudes llegaron por la misma conexión de servidor. Ahora los dos workers creen que tienen el trabajo para ellos solos. Con un pool más grande, falla de otra forma pero igual de mal: el desbloqueo del worker A cae en otra conexión de servidor, Postgres responde con una advertencia de que no eres dueño del bloqueo, y el bloqueo sigue tomado en la conexión de servidor original después de que A terminó. (pooled -c "SELECT pg_advisory_unlock_all();" libera el bloqueo del laboratorio.)
La solución: toma el bloqueo para la transacción. pg_advisory_xact_lock() y pg_try_advisory_xact_lock() liberan el bloqueo en el COMMIT o el ROLLBACK, así que el bloqueo y el trabajo comparten la transacción y la conexión de servidor. Para ver cómo excluye a un segundo worker, fija default_pool_size = 2 en el laboratorio y reinicia PgBouncer, para que los dos workers puedan ejecutarse a la vez:
docker restart pgbouncer
pooled -c "BEGIN; SELECT pg_advisory_xact_lock(42); SELECT pg_sleep(3); COMMIT;" > /dev/null &
sleep 1
pooled -c "SELECT pg_try_advisory_xact_lock(42) AS got_it;"
wait got_it
--------
f
(1 row)El trabajo tiene que caber en una transacción. Si no cabe, toma el bloqueo de sesión sobre la conexión directa.
Una forma común de fijar un valor por defecto por conexión es el parámetro options de la cadena de conexión. PgBouncer lo rechaza:
psql -X "host=localhost port=6432 user=app dbname=app options=-cstatement_timeout=5s" -c "SELECT 1"psql: error: connection to server at "localhost" (::1), port 6432 failed: FATAL: unsupported startup parameter in options: statement_timeoutPgBouncer solo acepta los parámetros de inicio que puede rastrear. Puedes hacer que ignore los desconocidos (ignore_startup_parameters), pero entonces la configuración se descarta en silencio, lo que es peor. El endpoint con pooling de Relyt One tampoco deja pasar options. Usa ALTER ROLE … SET de la sección 1 para los valores por defecto, o SET LOCAL para una transacción.
Estos tres necesitan una sesión que sobreviva a una transacción, y la tabla de funciones de PgBouncer los marca como "Never" para el pooling por transacción:
LISTENregistra la conexión de servidor, no tu cliente, así que las notificaciones van al cliente que en ese momento tenga esa conexión de servidor, o a nadie. Enviar conNOTIFYfunciona.- Los cursores
WITH HOLDsiguen abiertos en la conexión de servidor después delCOMMIT; tu siguienteFETCHpuede caer en otro sitio. - Las tablas temporales que sobreviven a su transacción se filtran a otros clientes. Aquí el cliente A crea una y el cliente B, que nunca la creó, puede consultarla:
pooled -c "CREATE TEMP TABLE scratch (id int);"
pooled -c "SELECT count(*) FROM scratch;"CREATE TABLE
count
-------
0
(1 row)Una tabla temporal creada con ON COMMIT DROP desaparece al final de su transacción y es segura. Para lo demás, usa la conexión directa.
Relyt One te da dos cadenas de conexión para un cómputo. En el diálogo Connect (Conectar), el interruptor Connection pooling (agrupación de conexiones) elige entre ellas. La de pooling pasa por PgBouncer con pooling a nivel de transacción y admite hasta 10.000 conexiones de cliente simultáneas; la directa es una sesión normal de Postgres con todas las funciones de arriba.
| Usa la conexión con pooling para | Usa la conexión directa para |
|---|---|
| Funciones serverless y edge que abren una conexión por invocación | Migraciones de esquema (por qué requieren cuidado de todos modos) |
| Solicitudes web que ejecutan unas pocas transacciones cortas | LISTEN, cursores WITH HOLD, tablas temporales de sesión |
| Muchas instancias de la aplicación que de otro modo tendrían cada una sus propias conexiones | Advisory locks de sesión y trabajos de larga duración |
Código que mantiene el estado dentro de transacciones (SET LOCAL, set_config(…, true)) | Drivers o herramientas que dependen de prepared statements |
psql, clientes gráficos y tareas de administración |
Las dos cadenas de conexión apuntan a la misma base de datos, así que puedes usar ambas desde una misma aplicación: la de pooling para el tráfico de solicitudes y la directa para el paso de migración y para el worker en segundo plano que escucha notificaciones.
- Busca en tu código cada
SETsimple (unSETdentro deBEGIN … COMMITsigue vivo después del commit) y reemplázalo porSET LOCALoset_config(…, true)dentro de una transacción. - Saca los valores por defecto por conexión de
options=y llévalos aALTER ROLE … SET. - Desactiva los prepared statements con nombre en tu driver (tabla de la sección 2).
- Reemplaza
pg_advisory_lock()porpg_advisory_xact_lock(), o mueve ese trabajo a la conexión directa. - Mueve
LISTEN, los cursoresWITH HOLDy las tablas temporales de sesión a la conexión directa. - Mantén las migraciones en la conexión directa.
- Prueba con un pool pequeño. Como muestra el laboratorio, un pool de uno convierte bugs intermitentes de producción en errores que ocurren en cada ejecución.
EtiquetasPostgrespgbouncerconnection-poolingserverless


