
Presentamos Relyt One: Postgres serverless que se ramifica como el código
Relyt One es PostgreSQL 17 serverless con ramas copy-on-write, cómputo que se suspende cuando está inactivo, búsqueda vectorial integrada y autenticación gestionada. Te contamos cómo funciona y cómo pasar del inicio de sesión a una base de datos con ramas en cinco minutos.
En esta página

Relyt One es Postgres serverless para desarrolladores y agentes de IA. Obtienes PostgreSQL 17 estándar, una rama de base de datos para cada pull request, cada vista previa y cada ejecución de un agente, cómputo que se suspende cuando nadie lo usa y las piezas que la mayoría de las aplicaciones terminan agregando por su cuenta: agrupación de conexiones, búsqueda vectorial, una Open API y autenticación gestionada. Empezar es gratis, no se pide tarjeta de crédito y puedes iniciar sesión con GitHub o Google y tener una base de datos unos minutos después.
Este artículo explica qué es Relyt One, por qué está construido así y cómo es trabajar con él en la práctica, desde la primera cadena de conexión hasta una rama desechable con datos de producción.
Postgres es la base de datos por defecto para las aplicaciones nuevas, y con razón. Lo que no ha cambiado mucho es la forma de operarla. Una instancia de Postgres administrada sigue siendo, en el fondo, una máquina: una cantidad fija de CPU y memoria con un disco conectado, funcionando aunque nadie le hable.
Ese modelo tiene tres costos que tarde o temprano aparecen en todos los equipos.
Los entornos son caros, así que hay muy pocos. Todos quieren una base de datos de staging que se parezca a producción, una base de datos por pull request, un sandbox donde una migración pueda fallar sin consecuencias. Con un Postgres con forma de máquina, cada una de esas cosas es otra instancia que aprovisionar, otro volcado que restaurar, otra factura. Así que los equipos comparten una sola base de datos de staging, prueban las migraciones con unas pocas filas de ejemplo y descubren el ALTER TABLE lento en producción.
Una base de datos inactiva cuesta lo mismo que una ocupada. Los proyectos personales, las herramientas internas, los entornos de vista previa y las aplicaciones de demostración pasan la mayor parte de su vida sin hacer nada. Una máquina siempre encendida te cobra por todo ese no hacer nada.
Los agentes empeoran ambos problemas. Un agente de programación que puede crear una base de datos para cada tarea, probar un cambio de esquema, ejecutar las pruebas y desechar el resultado es mucho más útil que uno que tiene que compartir tu base de datos de desarrollo. Pero eso solo funciona si crear una base de datos es tan barato y rápido como crear una rama de git.
Relyt One parte de una arquitectura distinta para que los tres problemas desaparezcan.
La idea central es que el cómputo y el almacenamiento están separados.
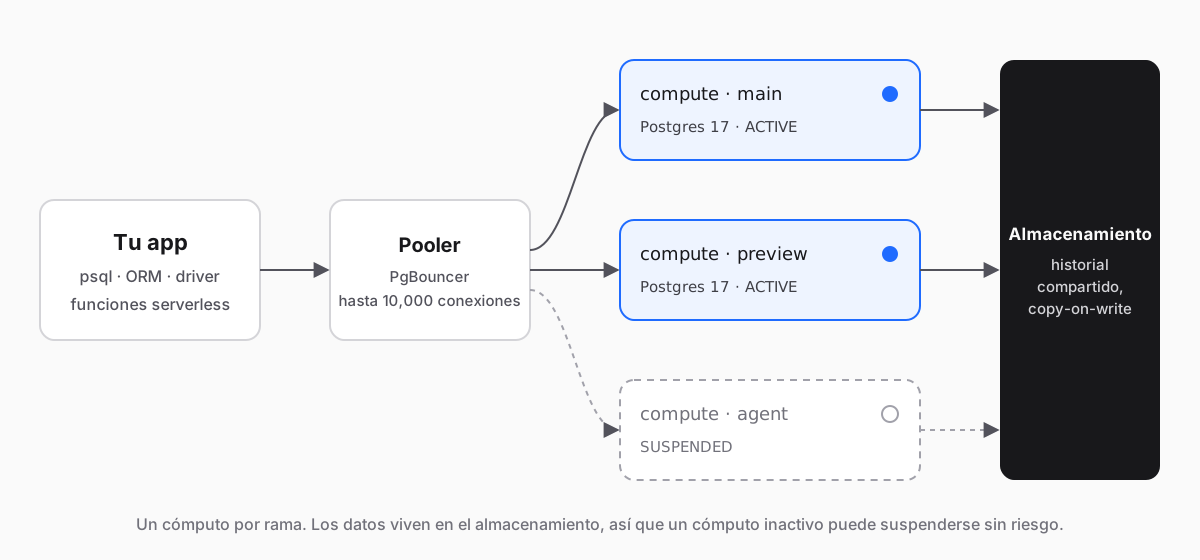
El almacenamiento es una capa compartida que guarda el historial de tus datos. El cómputo es un proceso normal de Postgres 17 que atiende las consultas de una rama y lee sus páginas desde el almacenamiento. Como los datos no viven en el disco del cómputo, tres cosas que antes eran caras pasan a ser baratas.
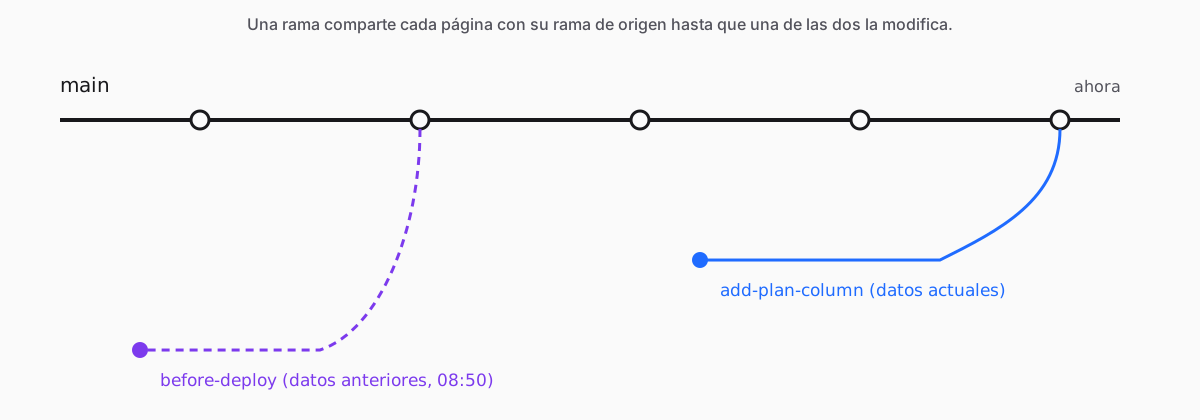
Una rama es una nueva línea de historial que parte de su rama de origen en un momento dado. Crearla no copia tus datos: la nueva rama comparte cada página con su rama de origen hasta que una de las dos la modifica, y solo las páginas modificadas ocupan espacio nuevo. Por eso crear una rama cuesta lo mismo si la rama de origen tiene un megabyte o cien gigabytes, y por eso la consola puede mostrarte, para cada rama, su diferencia de almacenamiento respecto de la rama de origen en lugar de una copia completa. El cómputo de la nueva rama tarda un poco en aprovisionarse; los datos están ahí desde el primer momento.
Las ramas forman un árbol. Puedes crear una rama desde main y volver a crear otra desde esa rama. Eliminar una rama nunca afecta a su rama de origen ni a sus ramas hermanas; una rama que todavía tiene ramas secundarias debe esperar a que estas desaparezcan. La rama principal no se puede eliminar, así que main siempre está ahí.
También puedes crear una rama desde el pasado. Cuando un proyecto conserva historial (hasta las últimas 3 horas, según la configuración de retención del historial del proyecto), una rama nueva puede partir de los datos de la rama de origen en cualquier momento dentro de esa ventana en lugar de partir de «ahora». Es útil para la mañana de la migración fallida: crea una rama desde diez minutos antes del despliegue, revisa cómo estaban las filas y copia de vuelta lo que necesites.
Cada rama se atiende con su propio cómputo, dimensionado en unidades de cómputo (1 CU = 1 vCPU + 4 GB de RAM). Una ejecución de pruebas pesada en una rama de vista previa nunca compite por CPU con producción, y el experimento de un agente no puede bloquear las tablas que están leyendo tus usuarios.
Cuando un cómputo lleva un rato sin nada que hacer (unos diez minutos de forma predeterminada), se suspende: su estado pasa de ACTIVE (activo) a SUSPENDED (suspendido) y deja de usar CPU. Tus datos quedan intactos, porque nunca estuvieron en el cómputo. La siguiente conexión lo reanuda. Para la larga cola de bases de datos que están ocupadas unos minutos al día, esa es la diferencia entre pagar por una máquina y pagar por trabajo.
- PostgreSQL 17, no una imitación. Tus drivers, ORM,
psql, pgAdmin y DBeaver funcionan sin cambios. Extensiones comopg_trgm,citextypgcryptoestán disponibles conCREATE EXTENSION. - Ramas a partir de los datos actuales o de las últimas horas, cada una con su propio cómputo, creadas desde la consola o la API.
- Agrupación de conexiones con PgBouncer en modo de transacción, para hasta 10,000 conexiones simultáneas. Usa la cadena de conexión con pooling para funciones serverless y otras conexiones de corta duración.
- Búsqueda vectorial integrada. La extensión
vectors(pgvecto.rs, no pgvector) viene precargada y se crea por defecto en tus bases de datos, así que los embeddings viven junto a las filas que describen. - Observabilidad para cada cómputo: gráficos de CPU, memoria, conexiones y tamaño de la base de datos, consultas activas en vivo e historial de consultas con número de llamadas y tiempos.
- Una Open API con claves de API que cubre organizaciones, proyectos, ramas y cómputos.
- Autenticación gestionada (vista previa). Inicio de sesión para los usuarios de tu aplicación, asociado a una rama, con los usuarios guardados en la propia base de datos de esa rama. Más detalles en Autenticación gestionada para Relyt One, ya en vista previa.
Este es el ciclo completo: crear un proyecto, conectarte, crear una rama, cambiar el esquema en la rama y desechar la rama.
Inicia sesión con GitHub o Google. En el primer inicio de sesión se crea para ti una organización gratuita.
Crea un proyecto: ponle un nombre, elige una región y define la contraseña de PostgreSQL. El proyecto empieza con una rama principal, main, un cómputo principal, una base de datos relytdb y su rol propietario relytdb_owner. Aprovisionar el cómputo puede tardar unos minutos; la página de la rama te avisa cuando está listo.
Abre la rama y elige Connect (conectar). Selecciona el cómputo, la base de datos y el rol, y copia la cadena de conexión. El diálogo también incluye fragmentos listos para usar con Prisma y Java, los datos de host y puerto para clientes gráficos y la cadena de conexión con pooling.
export DATABASE_URL="postgresql://<rol>:<contraseña>@<host>/<base_de_datos>?sslmode=require"
psql "$DATABASE_URL" -c "select version();"
Crea una tabla y algunas filas para tener algo que ramificar:
CREATE TABLE customers (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email      text NOT NULL UNIQUE,
  created_at timestamptz NOT NULL DEFAULT now()
);

INSERT INTO customers (email)
SELECT 'user' || g || '@example.com' FROM generate_series(1, 100000) AS g;En la página Branches (ramas), elige New Branch (nueva rama), selecciona main como rama de origen y deja Current data (datos actuales). Llámala add-plan-column.
La rama tiene las 100,000 filas desde el principio, además de su propio cómputo y su propia cadena de conexión; en cuanto el cómputo indique que está listo, conéctate a él. No se copió nada: la diferencia de almacenamiento respecto de la rama de origen empieza en cero.
Lo mismo con la Open API, que es lo que usaría un job de CI o un agente ($PROJECT_ID es el id obj-… del proyecto y parentBranchSlug es el slug br-… de la rama de origen):
curl https://relyt.one/api/v1/projects/$PROJECT_ID/branches \
  -H "x-api-key: $RELYT_API_KEY" \
  -H "content-type: application/json" \
  -d '{"name": "add-plan-column", "parentBranchSlug": "br-..."}'
Agrega "pointInTime": "2026-10-30T08:50:00Z" para crear la rama a partir de la rama de origen tal como estaba en ese momento; la hora tiene que caer dentro de la ventana de retención del historial del proyecto.
Conéctate a la rama y ejecuta la migración de la que no estás seguro:
ALTER TABLE customers ADD COLUMN plan text NOT NULL DEFAULT 'free';
CREATE INDEX customers_plan_idx ON customers (plan);
Descubres cuánto tarda con datos reales, cómo quedan después los planes de consulta y si tu aplicación sigue funcionando, todo sin tocar main. Abre Monitoring (monitoreo), elige el cómputo de la rama y verás el pico de CPU y las sentencias en Query History (historial de consultas).
¿Te gusta el resultado? Ejecuta la misma migración en main con tu despliegue habitual. ¿No te convence? Elimina la rama. En cualquier caso, el experimento te costó unos segundos de cómputo y las páginas que modificó.
Crear y eliminar proyectos y ramas es una llamada a la API, lo que hace de Relyt One una buena opción para los agentes de programación que necesitan una base de datos real para cada tarea.
- La Open API crea y elimina proyectos y ramas (cada rama viene con su propio cómputo), consulta el estado y las métricas de los cómputos y administra las claves de API. La referencia de la API enumera todos los endpoints.
- El paquete de skills para agentes, de código abierto, enseña a Claude Code y a otros agentes a aprovisionar, crear ramas y conectarse, para que no tengan que adivinar.
- Una rama por tarea. Dale a un agente su propia rama, deja que ejecute ahí las migraciones y las pruebas, y revisa el diff antes de que algo llegue a
main.
Todas las cuentas empiezan en el plan Free (Gratuito):
| Gratuito | |
|---|---|
| Organizaciones | 1 |
| Proyectos | 5 |
| Almacenamiento | 2.5 GB (incluye 0.5 GB por proyecto) |
| Cómputo | Horas de cómputo compartido ilimitadas (oferta de lanzamiento) |
No se pide tarjeta de crédito y no hay periodo de prueba que se agote.
La base de datos es Postgres, y las herramientas que la rodean son abiertas: @relyt/auth para verificar los tokens de la autenticación gestionada, aplicaciones de ejemplo y las skills para agentes, todo con licencia MIT en GitHub.
Inicia sesión, crea un proyecto y crea una rama. Si algo resulta confuso o no funciona, queremos saberlo: usa el botón de comentarios de la consola.
EtiquetasPostgresserverlessbranching


