
Découvrez Relyt One : le Postgres serverless qui se branche comme du code
Relyt One est un PostgreSQL 17 serverless avec des branches en copie sur écriture, un calcul qui se suspend en cas d’inactivité, une recherche vectorielle intégrée et une authentification gérée. Voici comment il fonctionne et comment passer de la connexion à une base de données avec branches en cinq minutes.
Sur cette page

Relyt One est un Postgres serverless pour les développeurs et les agents d’IA. Vous disposez d’un PostgreSQL 17 standard, d’une branche de base de données pour chaque pull request, chaque préversion et chaque exécution d’agent, d’un calcul qui se suspend quand personne ne l’utilise, et des briques que la plupart des applications finissent par greffer : pool de connexions, recherche vectorielle, Open API et authentification gérée. C’est gratuit pour commencer, sans carte bancaire, et vous pouvez vous connecter avec GitHub ou Google et disposer d’une base de données quelques minutes plus tard.
Cet article explique ce qu’est Relyt One, pourquoi il est conçu ainsi et à quoi ressemble concrètement le travail avec lui, de la première chaîne de connexion jusqu’à une branche jetable contenant des données de production.
Postgres est la base de données par défaut des nouvelles applications, et ce n’est pas un hasard. Ce qui a peu changé, c’est la façon dont on l’exploite. Une instance Postgres managée reste, au fond, une machine : une quantité fixe de CPU et de mémoire avec un disque attaché, qui tourne que quelqu’un lui parle ou non.
Ce modèle a trois coûts qui finissent par apparaître dans toutes les équipes.
Les environnements coûtent cher, donc il y en a trop peu. Tout le monde veut une base de staging qui ressemble à la production, une base de données par pull request, un bac à sable où une migration peut échouer sans risque. Avec un Postgres en forme de machine, chacun de ces besoins est une instance de plus à provisionner, un dump de plus à restaurer, une facture de plus. Alors les équipes partagent une seule base de staging, testent les migrations sur quelques lignes d’amorçage et découvrent le ALTER TABLE trop lent en production.
Une base de données inactive coûte autant qu’une base occupée. Projets perso, outils internes, environnements de préversion et applications de démonstration passent l’essentiel de leur existence à ne rien faire. Une machine toujours allumée vous facture tout ce rien.
Les agents aggravent les deux problèmes. Un agent de code capable de créer une base de données pour chaque tâche, d’essayer une modification de schéma, de lancer les tests puis de jeter le résultat est bien plus utile qu’un agent qui doit partager votre base de développement. Mais cela ne fonctionne que si une base de données est aussi rapide et bon marché à créer qu’une branche git.
Relyt One part d’une architecture différente pour faire disparaître ces trois problèmes.
L’idée centrale est que le calcul et le stockage sont séparés.
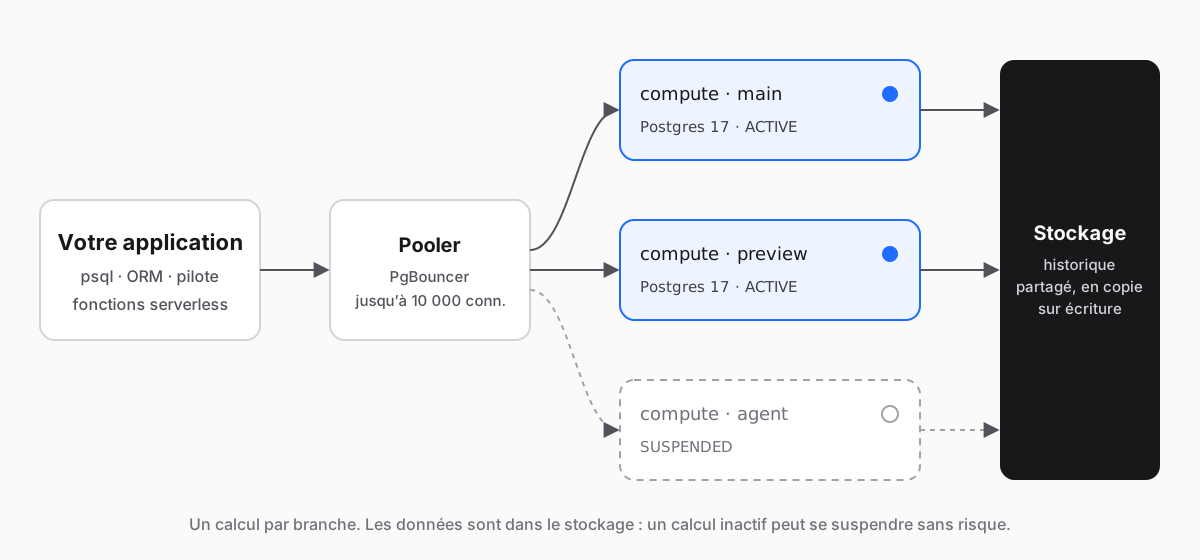
Le stockage est une couche partagée qui conserve l’historique de vos données. Le calcul est un processus Postgres 17 ordinaire qui sert les requêtes d’une branche et lit ses pages depuis le stockage. Comme les données ne résident pas sur le disque de l’instance de calcul, trois choses autrefois coûteuses deviennent bon marché.
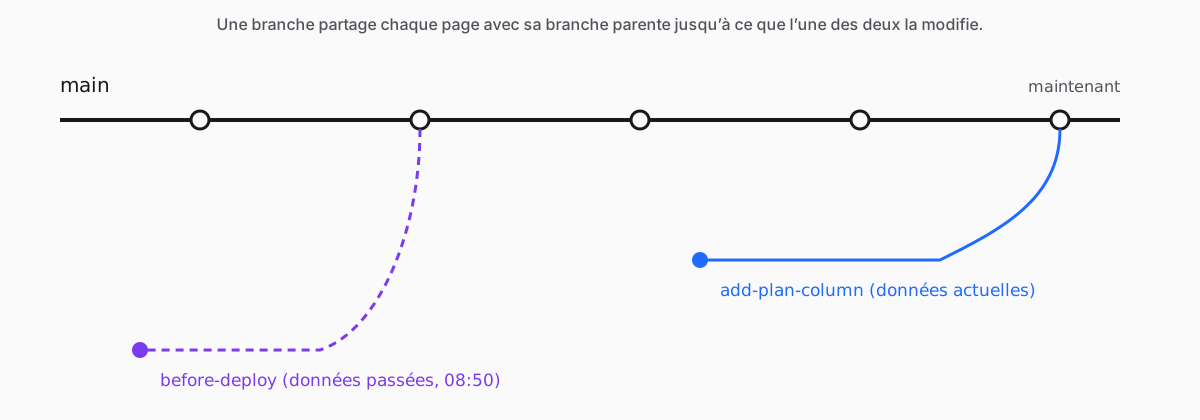
Une branche est une nouvelle ligne d’historique qui part de sa branche parente à un instant donné. En créer une ne copie pas vos données : la nouvelle branche partage chaque page avec sa branche parente jusqu’à ce que l’une des deux la modifie, et seules les pages modifiées occupent de la nouvelle place. C’est pourquoi créer une branche coûte la même chose, que la branche parente contienne un mégaoctet ou cent gigaoctets, et pourquoi la console peut vous montrer pour chaque branche son écart de stockage par rapport à la branche parente plutôt qu’une copie complète. Le provisionnement de l’instance de calcul de la nouvelle branche prend un petit moment ; les données, elles, sont là immédiatement.
Les branches forment un arbre. Vous pouvez créer une branche à partir de main, puis une autre à partir de cette branche. Supprimer une branche ne touche jamais sa branche parente ni ses branches sœurs ; une branche qui a encore des branches enfants doit attendre qu’elles aient disparu. La branche principale ne peut pas être supprimée, si bien que main est toujours là.
Vous pouvez aussi créer une branche à partir du passé. Lorsqu’un projet conserve son historique (jusqu’aux 3 dernières heures, selon le paramètre de conservation de l’historique du projet), une nouvelle branche peut partir des données de la branche parente à n’importe quel moment de cette fenêtre plutôt que de « maintenant ». C’est utile le matin d’une migration ratée : créez une branche à partir de dix minutes avant le déploiement, regardez à quoi ressemblaient les lignes et recopiez ce dont vous avez besoin.
Chaque branche est servie par sa propre instance de calcul, dimensionnée en unités de calcul (1 CU = 1 vCPU + 4 GB RAM). Une lourde série de tests sur une branche de préversion n’entre jamais en concurrence avec la production pour le CPU, et l’expérience d’un agent ne peut pas verrouiller les tables que lisent vos utilisateurs.
Lorsqu’une instance de calcul n’a rien eu à faire pendant un moment (environ dix minutes par défaut), elle se suspend : son statut passe de ACTIVE à SUSPENDED et elle cesse d’utiliser du CPU. Vos données ne sont pas touchées, puisqu’elles n’ont jamais été sur l’instance de calcul. La connexion suivante la réveille. Pour la longue traîne des bases de données occupées quelques minutes par jour, c’est la différence entre payer une machine et payer du travail.
- PostgreSQL 17, pas une imitation. Vos pilotes, ORM,
psql, pgAdmin et DBeaver fonctionnent sans modification. Des extensions commepg_trgm,citextetpgcryptosont disponibles avecCREATE EXTENSION. - Des branches à partir des données actuelles ou des dernières heures, chacune avec sa propre instance de calcul, créées depuis la console ou l’API.
- Un pool de connexions via PgBouncer avec un pooling au niveau des transactions, pour jusqu’à 10 000 connexions simultanées. Utilisez la chaîne de connexion poolée pour les fonctions serverless et les autres connexions de courte durée.
- La recherche vectorielle intégrée. L’extension
vectors(pgvecto.rs, pas pgvector) est préchargée et créée par défaut dans vos bases de données : les embeddings vivent à côté des lignes qu’ils décrivent. - L’observabilité de chaque instance de calcul : graphiques du CPU, de la mémoire, des connexions et de la taille des bases de données, requêtes actives en direct et historique des requêtes avec nombre d’appels et temps d’exécution.
- Une Open API avec des clés API qui couvre les organisations, les projets, les branches et les instances de calcul.
- L’authentification gérée (préversion). La connexion des utilisateurs de votre application, rattachée à une branche, avec des utilisateurs stockés dans la base de données de cette même branche. Pour en savoir plus, lisez L’authentification gérée de Relyt One, désormais en préversion.
Voici la boucle complète : créer un projet, s’y connecter, créer une branche, modifier le schéma sur la branche, puis jeter la branche.
Connectez-vous avec GitHub ou Google. Une organisation gratuite est créée pour vous lors de la première connexion.
Créez un projet : donnez-lui un nom, choisissez une région et définissez le mot de passe PostgreSQL. Le projet démarre avec une branche principale, main, un calcul principal, une base de données relytdb et son rôle propriétaire relytdb_owner. Le provisionnement de l’instance de calcul peut prendre quelques minutes ; la page de la branche vous indique quand elle est prête.
Ouvrez la branche et choisissez Connect (Connexion). Choisissez l’instance de calcul, la base de données et le rôle, puis copiez la chaîne de connexion. La boîte de dialogue propose aussi des extraits prêts à l’emploi pour Prisma et Java, l’hôte et le port pour les clients graphiques, ainsi que la chaîne de connexion poolée.
export DATABASE_URL="postgresql://<rôle>:<mot-de-passe>@<hôte>/<base-de-données>?sslmode=require"
psql "$DATABASE_URL" -c "select version();"
Créez une table et quelques lignes pour avoir de quoi créer une branche :
CREATE TABLE customers (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email      text NOT NULL UNIQUE,
  created_at timestamptz NOT NULL DEFAULT now()
);

INSERT INTO customers (email)
SELECT 'user' || g || '@example.com' FROM generate_series(1, 100000) AS g;Sur la page Branches, choisissez New Branch (Nouvelle branche), sélectionnez main comme branche parente et laissez Current data (Données actuelles). Nommez-la add-plan-column.
La branche contient dès le départ les 100 000 lignes, plus sa propre instance de calcul et sa propre chaîne de connexion ; dès que l’instance de calcul est prête, connectez-vous-y. Rien n’a été copié : l’écart de stockage par rapport à la branche parente part de zéro.
La même chose via l’Open API, ce qu’utiliserait un job de CI ou un agent ($PROJECT_ID est l’identifiant obj-… du projet, et parentBranchSlug est le slug br-… de la branche parente) :
curl https://relyt.one/api/v1/projects/$PROJECT_ID/branches \
  -H "x-api-key: $RELYT_API_KEY" \
  -H "content-type: application/json" \
  -d '{"name": "add-plan-column", "parentBranchSlug": "br-..."}'
Ajoutez "pointInTime": "2026-10-30T08:50:00Z" pour créer plutôt la branche à partir de l’état de la branche parente à cet instant ; l’heure doit se situer dans la fenêtre de conservation de l’historique du projet.
Connectez-vous à la branche et lancez la migration dont vous n’êtes pas sûr :
ALTER TABLE customers ADD COLUMN plan text NOT NULL DEFAULT 'free';
CREATE INDEX customers_plan_idx ON customers (plan);
Vous découvrez combien de temps elle prend sur des données réelles, à quoi ressemblent ensuite les plans de requête et si votre application fonctionne toujours, le tout sans toucher à main. Ouvrez Monitoring (Supervision), choisissez l’instance de calcul de la branche, et vous verrez le pic de CPU ainsi que les instructions dans Query History (Historique des requêtes).
Le résultat vous convient ? Lancez la même migration sur main via votre déploiement habituel. Il ne vous convient pas ? Supprimez la branche. Dans les deux cas, l’expérience vous a coûté quelques secondes de calcul et les pages qu’elle a modifiées.
Créer et supprimer des projets et des branches se fait par un appel d’API, ce qui fait de Relyt One un bon choix pour les agents de code qui ont besoin d’une vraie base de données pour chaque tâche.
- L’Open API crée et supprime des projets et des branches (chaque branche est livrée avec sa propre instance de calcul), lit le statut et les métriques des instances de calcul, et gère les clés API. La référence de l’API liste tous les endpoints.
- Le pack de skills pour agents open source apprend à Claude Code et à d’autres agents à provisionner, créer des branches et se connecter, pour qu’ils n’aient pas à deviner.
- Une branche par tâche. Donnez à un agent sa propre branche, laissez-le y lancer migrations et tests, et relisez le diff avant que quoi que ce soit n’atteigne
main.
Chaque compte démarre avec le forfait Free (Gratuit) :
| Gratuit | |
|---|---|
| Organisations | 1 |
| Projets | 5 |
| Stockage | 2,5 GB (0,5 GB inclus par projet) |
| Calcul | Heures de calcul partagé illimitées (offre de lancement) |
Pas de carte bancaire, pas de période d’essai qui s’écoule.
La base de données est Postgres, et les outils qui l’entourent sont ouverts : @relyt/auth pour vérifier les jetons de l’authentification gérée, des applications d’exemple et les skills pour agents, tous sous licence MIT sur GitHub.
Connectez-vous, créez un projet et créez-en une branche. Si quelque chose vous paraît confus ou ne fonctionne pas, nous voulons le savoir : utilisez le bouton d’avis dans la console.
ÉtiquettesPostgresserverlessbranching


