
Ce qui casse derrière le pooling en mode transaction de PgBouncer, et comment corriger chaque cas
Pourquoi vous obtenez « prepared statement already exists », des paramètres qui fuient d’une requête à l’autre et des verrous consultatifs qui ne verrouillent rien derrière un pooler en mode transaction, reproduits sur PgBouncer 1.24 et PostgreSQL 17, avec la correction de chaque cas et une règle pour savoir quand utiliser plutôt la connexion directe.
Sur cette page

Placez PgBouncer en mode transaction devant Postgres, et des milliers de clients éphémères peuvent se partager quelques dizaines de connexions serveur. Le prix à payer, c’est que « ma connexion » ne veut plus rien dire entre deux transactions. C’est de là que viennent des erreurs comme prepared statement "s0" already exists, ainsi qu’un SET qui apparaît dans la requête de quelqu’un d’autre et un verrou consultatif que deux workers détiennent tous les deux. Cet article reproduit chacun de ces cas sur un PgBouncer 1.24.1 et un PostgreSQL 17.11 locaux, configurés comme la chaîne de connexion poolée de Relyt One (mode transaction, Postgres 17), montre la correction de chacun, et se termine par une règle pour savoir quand se passer du pooler. Chaque commande et chaque sortie ci-dessous ont été exécutées sur cette configuration locale.
En mode transaction, PgBouncer prête à un client une connexion serveur pour une transaction et la reprend au COMMIT ou au ROLLBACK. Une instruction hors d’une transaction explicite constitue une transaction à elle seule. Tout ce qui vit sur la connexion serveur plus longtemps qu’une transaction fuit vers le client suivant ou manque à la transaction suivante. Voici les victimes, d’après le tableau des fonctionnalités de PgBouncer, sa référence de configuration et notre labo :
| Vous utilisez | Ce qui ne va pas | Correction |
|---|---|---|
SET statement_timeout, SET search_path, … | Le paramètre reste sur la connexion serveur et s’applique au client qui la récupère ensuite, quel qu’il soit | SET LOCAL ou set_config(…, true) dans une transaction ; ALTER ROLE … SET pour les valeurs par défaut |
PREPARE / EXECUTE en SQL | Erreurs already exists / does not exist | N’utilisez pas de requêtes préparées au niveau SQL à travers le pooler |
| Les requêtes préparées nommées de votre pilote | Les mêmes erreurs, venant du pilote | Désactivez-les dans le pilote, ou utilisez un pooler où max_prepared_statements est défini |
pg_advisory_lock() | Deux clients peuvent « détenir » tous les deux le même verrou | pg_advisory_xact_lock() dans une transaction |
options=-c … dans la chaîne de connexion | Connexion refusée | ALTER ROLE … SET, ou SET LOCAL à chaque transaction |
LISTEN, curseurs WITH HOLD, tables temporaires qui survivent à une transaction | Résultats peu fiables ou faux | Utilisez la connexion directe |
La suite de l’article montre chaque ligne en action.
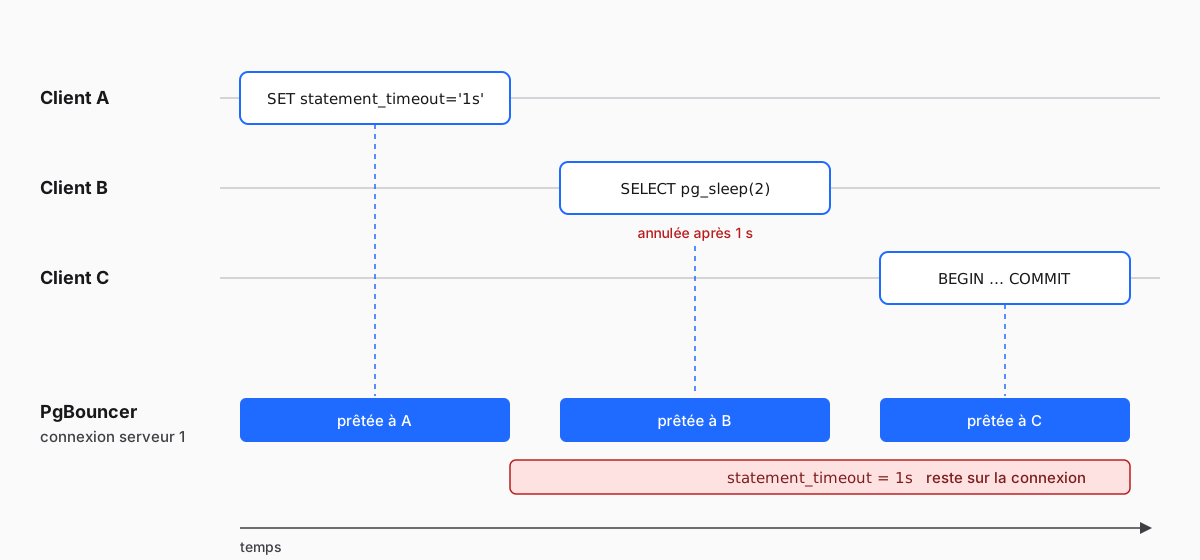
Deux détails de la référence de configuration de PgBouncer expliquent l’essentiel de ce qui suit :
- Rien n’est réinitialisé entre les clients.
server_reset_query(par défautDISCARD ALL) est « not used » en pooling en mode transaction. Tout ce qu’une transaction laisse sur la connexion serveur, le client suivant en hérite. - Certains paramètres sont suivis, les autres non. PgBouncer mémorise les valeurs de chaque client pour une courte liste de paramètres que Postgres renvoie au client (en 1.24 :
client_encoding,DateStyle,IntervalStyle,TimeZone,standard_conforming_stringsetapplication_name) et les restaure quand il confie une connexion serveur à ce client. Le tableau des fonctionnalités marque tout autreSETcomme incompatible avec le pooling en mode transaction : la modification reste sur la connexion serveur, pour le client suivant.
Tout ce qui suit s’exécute sur un Postgres 17.11 et un PgBouncer 1.24.1 locaux dans Docker. L’image PgBouncer est edoburu/pgbouncer, maintenue par la communauté. La configuration du pooler utilise le mode transaction et laisse désactivé le suivi des requêtes préparées, comme le pooler de Relyt One, mais fixe le pool à une seule connexion serveur. Avec une seule connexion serveur, tous les clients tombent sur la même, si bien que chaque défaillance se produit à chaque fois et non de temps en temps. En production, avec des dizaines de connexions serveur dans le pool, les mêmes défaillances sont intermittentes, et c’est précisément pour cela qu’elles sont difficiles à déboguer.
; pgbouncer.ini
[databases]
* = host=pg port=5432

[pgbouncer]
listen_addr = 0.0.0.0
listen_port = 6432
auth_type = scram-sha-256
auth_file = /etc/pgbouncer/userlist.txt
pool_mode = transaction
default_pool_size = 1
max_prepared_statements = 0
ignore_startup_parameters = extra_float_digitsecho '"app" "secret"' > userlist.txt
docker network create pgblab
docker run -d --name pg --network pgblab \
-e POSTGRES_USER=app -e POSTGRES_PASSWORD=secret -e POSTGRES_DB=app \
postgres:17.11-alpine
docker run -d --name pgbouncer --network pgblab -p 6432:6432 \
-v "$PWD/pgbouncer.ini:/etc/pgbouncer/pgbouncer.ini:ro" \
-v "$PWD/userlist.txt:/etc/pgbouncer/userlist.txt:ro" \
edoburu/pgbouncer:v1.24.1-p1
export PGPASSWORD=secretChaque psql -c ci-dessous est une connexion client distincte à PgBouncer, comme le seraient des requêtes distinctes d’une application web ou des invocations serverless distinctes. Collez d’abord cette fonction utilitaire dans votre shell :
pooled() { psql -X -h localhost -p 6432 -U app app "$@"; }Le client A définit un délai d’expiration des instructions d’une seconde, comme une application pourrait le faire au début d’une requête. Le client B est quelqu’un d’autre :
pooled -c "SET statement_timeout = '1s';"
pooled -c "SHOW statement_timeout;" -c "SELECT pg_sleep(2);"SET
statement_timeout
-------------------
1s
(1 row)
ERROR: canceling statement due to statement timeoutLe client B n’a jamais défini de délai, et sa requête de deux secondes a quand même été annulée. Le SET s’est exécuté dans une transaction à lui seul, la connexion serveur est retournée dans le pool en portant toujours statement_timeout = 1s, et B a récupéré cette connexion. Avec un pool plus grand, l’inverse se produit aussi : l’instruction suivante du client A atterrit sur une autre connexion serveur, où le délai n’a jamais été défini. En production, vous voyez les deux : un paramètre qui parfois ne s’applique pas, et des délais d’expiration ou un mauvais search_path dans des requêtes qui n’ont rien demandé.
Les paramètres suivis se comportent différemment. La même expérience avec SET TimeZone = 'Asia/Tokyo' suivi de SHOW TimeZone depuis un second client affiche UTC, car PgBouncer restaure la valeur propre à chaque client. search_path ne figure pas sur cette liste, et il fuit de la même façon que statement_timeout :
pooled -c "SET search_path = app_private, public;"
pooled -Atc "SHOW search_path;"SET
app_private, publicLa correction : limiter les paramètres à une transaction. SET LOCAL dure jusqu’à la fin de la transaction en cours, il s’applique donc à toutes ses instructions et disparaît avant que la connexion serveur ne retourne dans le pool :
pooled -c "BEGIN; SET LOCAL statement_timeout = '1s'; SHOW statement_timeout; COMMIT;"
pooled -Atc "SHOW statement_timeout;"BEGIN
SET
statement_timeout
-------------------
1s
(1 row)
COMMIT
0(Si vous suivez pas à pas, exécutez d’abord pooled -c "RESET statement_timeout;" -c "RESET search_path;" pour nettoyer après les fuites ci-dessus.) Depuis le code applicatif, set_config(name, value, true) fait la même chose que SET LOCAL et accepte des paramètres, ce qui en fait le moyen habituel de transmettre un ID utilisateur aux politiques de sécurité au niveau des lignes. Notre guide de l’authentification gérée utilise exactement ce modèle, et il tient derrière le pooler pour la même raison.
Pour un paramètre que toutes les connexions doivent avoir, attachez-le plutôt au rôle :
ALTER ROLE app SET statement_timeout = '5s';Postgres applique les paramètres de rôle au démarrage d’une connexion serveur. Les connexions serveur que PgBouncer a déjà ouvertes gardent leur ancienne valeur ; dans notre labo, SHOW statement_timeout à travers le pooler affichait encore 0 juste après l’ALTER ROLE, et 5s une fois que PgBouncer avait ouvert de nouvelles connexions serveur.
Les requêtes préparées au niveau SQL appartiennent à une connexion serveur. Deux clients qui préparent le même nom finissent tôt ou tard sur la même connexion serveur :
pooled -c "PREPARE get_one AS SELECT 1;"
pooled -c "PREPARE get_one AS SELECT 1;"PREPARE
ERROR: prepared statement "get_one" already existsPgBouncer ne suit jamais le PREPARE au niveau SQL : la référence de configuration indique qu’il transmet PREPARE, EXECUTE et DEALLOCATE à Postgres, quels que soient les réglages. À travers un pooler en mode transaction, ne les utilisez pas. (pooled -c "DEALLOCATE ALL;" nettoie le labo.)
La plupart des gens rencontrent plutôt cette erreur par l’intermédiaire de leur pilote. Beaucoup de pilotes utilisent des requêtes préparées au niveau du protocole, par défaut ou dès qu’une requête se répète : ils envoient la requête une fois sous un nom, puis l’exécutent par ce nom. Voici node-postgres (pg 8.23) exécutant une requête nommée depuis deux clients :
// named.js
const { Client } = require('pg');

async function main() {
  const url = process.env.DATABASE_URL;
  const a = new Client({ connectionString: url });
  const b = new Client({ connectionString: url });
  await a.connect();
  await b.connect();
  const query = { name: 'get-account', text: 'SELECT $1::int AS id' };
  try {
    console.log('a:', (await a.query({ ...query, values: [1] })).rows);
    console.log('b:', (await b.query({ ...query, values: [2] })).rows);
  } catch (err) {
    console.log('error:', err.message);
  } finally {
    await a.end();
    await b.end();
  }
}

main();npm install pg@8.23.1
DATABASE_URL=postgres://app:secret@localhost:6432/app node named.jsa: [ { id: 1 } ]
error: prepared statement "get-account" already existsLe cas symétrique nécessite un pool de deux connexions serveur. Le client A exécute la requête nommée, un autre client ouvre une transaction et prend la connexion serveur que A vient d’utiliser, et A exécute à nouveau la requête. Le pilote se souvient qu’il a déjà préparé get-account, n’envoie que le message « exécuter », et atterrit sur l’autre connexion serveur : prepared statement "get-account" does not exist. Nous avons reproduit les deux erreurs dans le labo.
PgBouncer 1.21 a ajouté une correction pour le cas du protocole : avec max_prepared_statements réglé au-dessus de zéro, il suit les requêtes que chaque client prépare et les prépare sur la connexion serveur que le client obtient, quelle qu’elle soit. Nous avons relancé les deux expériences avec max_prepared_statements = 200 et les deux erreurs ont disparu, tandis que le PREPARE au niveau SQL ci-dessus échouait toujours.
Sur la chaîne de connexion poolée de Relyt One, ce suivi est désactivé (max_prepared_statements = 0), désactivez donc les requêtes préparées nommées dans votre pilote quand vous vous connectez à travers le pooler :
| Pilote | À travers le pooler |
|---|---|
node-postgres (pg) | Ne passez pas name dans les configurations de requête. Les requêtes paramétrées simples (client.query(text, values)) utilisent une requête sans nom et fonctionnent bien ; nous l’avons vérifié dans le labo |
| psycopg 3 | Connectez-vous avec prepare_threshold=None, qui désactive les requêtes préparées |
| asyncpg | Passez statement_cache_size=0 à connect() ou create_pool(), comme le recommande sa FAQ pour PgBouncer |
| Prisma | Ajoutez pgbouncer=true à l’URL poolée, et exécutez les migrations sur une URL directe. Le guide de Prisma abandonne cette option pour PgBouncer 1.21 et versions ultérieures, mais cela suppose que max_prepared_statements est au-dessus de zéro, ce qui n’est pas le cas ici (voir le guide PgBouncer de Prisma) |
Vous renoncez au temps de planification économisé en préparant une requête une seule fois. Pour les requêtes courtes qu’exécute une requête web, ce coût est généralement faible à côté de l’aller-retour réseau ; si vous dépendez des requêtes préparées, utilisez la connexion directe.
Les verrous consultatifs au niveau de la session sont un moyen courant de garantir qu’un seul worker exécute une tâche. Ils appartiennent à la connexion serveur, et ils sont réentrants : la session qui détient un verrou peut le reprendre. Derrière un pooler en mode transaction, cela donne ceci :
pooled -c "SELECT pg_advisory_lock(42);"
pooled -c "SELECT pg_try_advisory_lock(42) AS got_it;" pg_advisory_lock
------------------
(1 row)
got_it
--------
t
(1 row)Le worker A a pris le verrou 42. Le worker B a demandé le même verrou, et Postgres a dit oui, car les deux demandes sont passées par la même connexion serveur. Les deux workers croient maintenant avoir la tâche pour eux seuls. Avec un pool plus grand, l’échec est différent mais tout aussi grave : le déverrouillage du worker A atterrit sur une autre connexion serveur, Postgres répond par un avertissement indiquant que vous ne détenez pas le verrou, et le verrou reste détenu sur la connexion serveur d’origine après que A a terminé. (pooled -c "SELECT pg_advisory_unlock_all();" libère le verrou du labo.)
La correction : prendre le verrou pour la transaction. pg_advisory_xact_lock() et pg_try_advisory_xact_lock() libèrent le verrou au COMMIT ou au ROLLBACK, si bien que le verrou et le travail partagent la transaction et la connexion serveur. Pour le voir exclure un second worker, réglez default_pool_size = 2 dans le labo et redémarrez PgBouncer, afin que les deux workers puissent s’exécuter en même temps :
docker restart pgbouncer
pooled -c "BEGIN; SELECT pg_advisory_xact_lock(42); SELECT pg_sleep(3); COMMIT;" > /dev/null &
sleep 1
pooled -c "SELECT pg_try_advisory_xact_lock(42) AS got_it;"
wait got_it
--------
f
(1 row)La tâche doit tenir dans une seule transaction. Si ce n’est pas possible, prenez le verrou de session sur la connexion directe.
Une façon courante de définir une valeur par défaut par connexion est le paramètre options dans la chaîne de connexion. PgBouncer le refuse :
psql -X "host=localhost port=6432 user=app dbname=app options=-cstatement_timeout=5s" -c "SELECT 1"psql: error: connection to server at "localhost" (::1), port 6432 failed: FATAL: unsupported startup parameter in options: statement_timeoutPgBouncer n’accepte que les paramètres de démarrage qu’il sait suivre. Vous pouvez lui faire ignorer les paramètres inconnus (ignore_startup_parameters), mais le paramètre est alors abandonné en silence, ce qui est pire. Le point de terminaison poolé de Relyt One ne transmet pas non plus options. Utilisez ALTER ROLE … SET de la section 1 pour les valeurs par défaut, ou SET LOCAL pour une transaction.
Ces trois fonctionnalités ont besoin d’une session qui survit à une transaction, et le tableau des fonctionnalités de PgBouncer les marque « Never » pour le pooling en mode transaction :
LISTENenregistre la connexion serveur, pas votre client, si bien que les notifications vont au client qui détient cette connexion serveur à ce moment-là, ou à personne. L’envoi avecNOTIFYfonctionne.- Les curseurs
WITH HOLDrestent ouverts sur la connexion serveur après leCOMMIT; votreFETCHsuivant peut atterrir ailleurs. - Les tables temporaires qui survivent à leur transaction fuient vers d’autres clients. Ici, le client A en crée une et le client B, qui ne l’a jamais créée, peut l’interroger :
pooled -c "CREATE TEMP TABLE scratch (id int);"
pooled -c "SELECT count(*) FROM scratch;"CREATE TABLE
count
-------
0
(1 row)Une table temporaire créée avec ON COMMIT DROP disparaît à la fin de sa transaction et ne pose pas de problème. Pour le reste, utilisez la connexion directe.
Relyt One vous donne deux chaînes de connexion pour une instance de calcul. Dans la boîte de dialogue Connect (Connexion), l’interrupteur Connection pooling (Pool de connexions) choisit entre les deux. La chaîne poolée passe par PgBouncer avec un pooling au niveau de la transaction et prend en charge jusqu’à 10 000 connexions client simultanées ; la chaîne directe est une session Postgres ordinaire avec toutes les fonctionnalités ci-dessus.
| Utilisez la connexion poolée pour | Utilisez la connexion directe pour |
|---|---|
| Les fonctions serverless et edge qui ouvrent une connexion à chaque invocation | Les migrations de schéma (pourquoi elles demandent de toute façon de la prudence) |
| Les requêtes web qui exécutent quelques transactions courtes | LISTEN, les curseurs WITH HOLD, les tables temporaires de session |
| De nombreuses instances d’application qui sinon garderaient chacune leurs propres connexions | Les verrous consultatifs de session et les tâches de longue durée |
Le code qui garde son état à l’intérieur des transactions (SET LOCAL, set_config(…, true)) | Les pilotes ou outils qui reposent sur les requêtes préparées |
psql, les clients graphiques et les tâches d’administration |
Les deux chaînes de connexion pointent vers la même base de données, vous pouvez donc utiliser les deux depuis une même application : la chaîne poolée pour le trafic des requêtes, et la directe pour l’étape de migration et pour le worker en arrière-plan qui écoute les notifications.
- Cherchez dans votre code chaque
SETsimple (unSETà l’intérieur deBEGIN … COMMITsurvit tout de même au commit), et remplacez-le parSET LOCALouset_config(…, true)dans une transaction. - Déplacez les valeurs par défaut par connexion hors de
options=et versALTER ROLE … SET. - Désactivez les requêtes préparées nommées dans votre pilote (tableau de la section 2).
- Remplacez
pg_advisory_lock()parpg_advisory_xact_lock(), ou déplacez cette tâche vers la connexion directe. - Déplacez
LISTEN, les curseursWITH HOLDet les tables temporaires de session vers la connexion directe. - Gardez les migrations sur la connexion directe.
- Testez avec un petit pool. Comme le montre le labo, un pool d’une seule connexion transforme des bugs intermittents en production en erreurs qui se produisent à chaque exécution.
ÉtiquettesPostgrespgbouncerconnection-poolingserverless


