
INSERT ... ON CONFLICT ou MERGE dans Postgres : quel upsert utiliser, et les erreurs que chacun déclenche
Quand faire un upsert avec INSERT ... ON CONFLICT et quand utiliser MERGE dans PostgreSQL 17, pourquoi MERGE peut échouer avec une erreur de clé dupliquée en cas de concurrence, et comment corriger « cannot affect row a second time », un RETURNING vide et « no unique or exclusion constraint matching the ON CONFLICT specification ». Chaque instruction a été reproduite sur Postgres 17.11.
Sur cette page

Postgres offre deux façons de dire « insérer cette ligne, ou la mettre à jour si elle existe déjà » : INSERT ... ON CONFLICT, disponible depuis la 9.5, et MERGE, ajouté en 15 et rendu beaucoup plus utile en 17 avec RETURNING, merge_action() et WHEN NOT MATCHED BY SOURCE. Ils semblent interchangeables, mais ils ne le sont pas. Deux sessions qui font un upsert sur la même nouvelle clé réussissent toutes les deux avec ON CONFLICT ; avec MERGE, l’une d’elles obtient une erreur de clé dupliquée. Cet article reproduit cette situation de concurrence ainsi que les cinq autres erreurs et surprises que l’on rencontre avec les upserts, montre la correction de chacune, et se termine par une règle pour choisir entre les deux. Chaque instruction et chaque sortie ci-dessous proviennent d’un PostgreSQL 17.11 local, la version majeure qu’exécute Relyt One.
Utilisez INSERT ... ON CONFLICT quand des écritures concurrentes peuvent insérer la même clé : un gestionnaire de requêtes, un consommateur de webhooks, un compteur. La documentation de Postgres garantit « un résultat atomique INSERT ou UPDATE ; en l’absence d’erreur indépendante, l’un de ces deux résultats est garanti, même en cas de forte concurrence ». Utilisez MERGE quand vous réconciliez tout un ensemble de lignes avec une table, comme un flux nocturne ou une table de staging, et que vous voulez des mises à jour conditionnelles, des suppressions, ou un compte rendu de ce qui est arrivé à chaque ligne.
| Vous rencontrez | Instruction | Pourquoi | Correction |
|---|---|---|---|
duplicate key value violates unique constraint | MERGE | Deux sessions insèrent la même nouvelle clé ; MERGE ne se rabat pas sur UPDATE | Utilisez ON CONFLICT pour ce chemin, ou réessayez sur le SQLSTATE 23505 |
ON CONFLICT DO UPDATE command cannot affect row a second time | INSERT ... ON CONFLICT | Le lot contient deux fois la même clé | Dédoublonnez le lot avec DISTINCT ON |
MERGE command cannot affect row a second time | MERGE | Deux lignes source correspondent à une même ligne cible | Dédoublonnez la source |
RETURNING revient vide | Les deux | Seules les lignes réellement insérées ou mises à jour sont renvoyées | Lisez la ligne existante dans la même instruction |
there is no unique or exclusion constraint matching the ON CONFLICT specification | INSERT ... ON CONFLICT | La cible du conflit ne correspond à aucun index unique | Ajoutez l’index, ou répétez le WHERE de l’index partiel |
| Des lignes réécrites alors que rien n’a changé | Les deux | Une mise à jour écrit une nouvelle version de ligne, même avec des valeurs identiques | Ajoutez WHERE ... IS DISTINCT FROM |
| Des trous dans vos ids | INSERT ... ON CONFLICT | L’id est tiré avant que le conflit soit détecté | Attendez-vous à des trous ; n’utilisez pas les ids comme un décompte |
N’importe quel Postgres 17 fait l’affaire. Avec Docker :
docker run -d --name upsert-lab -e POSTGRES_PASSWORD=secret postgres:17.11-alpine
docker exec -it upsert-lab psql -U postgres
Une seule table, dont la clé est une colonne d’identité, avec un sku unique :
CREATE TABLE products (
  id    bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  sku   text NOT NULL UNIQUE,
  name  text NOT NULL,
  price numeric(10,2) NOT NULL
);
L’upsert de base nomme la colonne en conflit, et EXCLUDED est la ligne que vous avez tenté d’insérer :
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 49.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price
RETURNING id, sku, price, (xmax = 0) AS inserted; id | sku | price | inserted
----+-------+-------+----------
1 | KB-01 | 49.00 | tExécutez-le à nouveau avec 45.00 et la même ligne revient mise à jour, avec inserted à false :
 id |  sku  | price | inserted
----+-------+-------+----------
  1 | KB-01 | 45.00 | f
Le test (xmax = 0) est une astuce très recopiée pour distinguer une insertion d’une mise à jour. Il fonctionne parce qu’une version de ligne fraîchement insérée n’a pas de xmax, mais il repose sur la façon dont Postgres stocke les versions de lignes, et non sur un comportement documenté. MERGE dispose d’un moyen documenté de signaler l’action, présenté à la fin de cet article.
Ouvrez deux sessions psql. Dans la première, démarrez une transaction et faites un upsert avec MERGE sur un SKU qui n’existe pas encore, mais ne validez pas :
-- Session A
BEGIN;
MERGE INTO products AS p
USING (VALUES ('WC-01', 'Webcam', 59.00)) AS f(sku, name, price)
ON p.sku = f.sku
WHEN MATCHED THEN UPDATE SET name = f.name, price = f.price
WHEN NOT MATCHED THEN INSERT (sku, name, price) VALUES (f.sku, f.name, f.price);
Dans la seconde session, exécutez le même MERGE pour le même SKU. Il reste bloqué :
-- Session B
MERGE INTO products AS p
USING (VALUES ('WC-01', 'Webcam', 55.00)) AS f(sku, name, price)
ON p.sku = f.sku
WHEN MATCHED THEN UPDATE SET name = f.name, price = f.price
WHEN NOT MATCHED THEN INSERT (sku, name, price) VALUES (f.sku, f.name, f.price);
Tapez COMMIT; dans la session A. La session B se réveille avec :
ERROR:  duplicate key value violates unique constraint "products_sku_key"
DETAIL:  Key (sku)=(WC-01) already exists.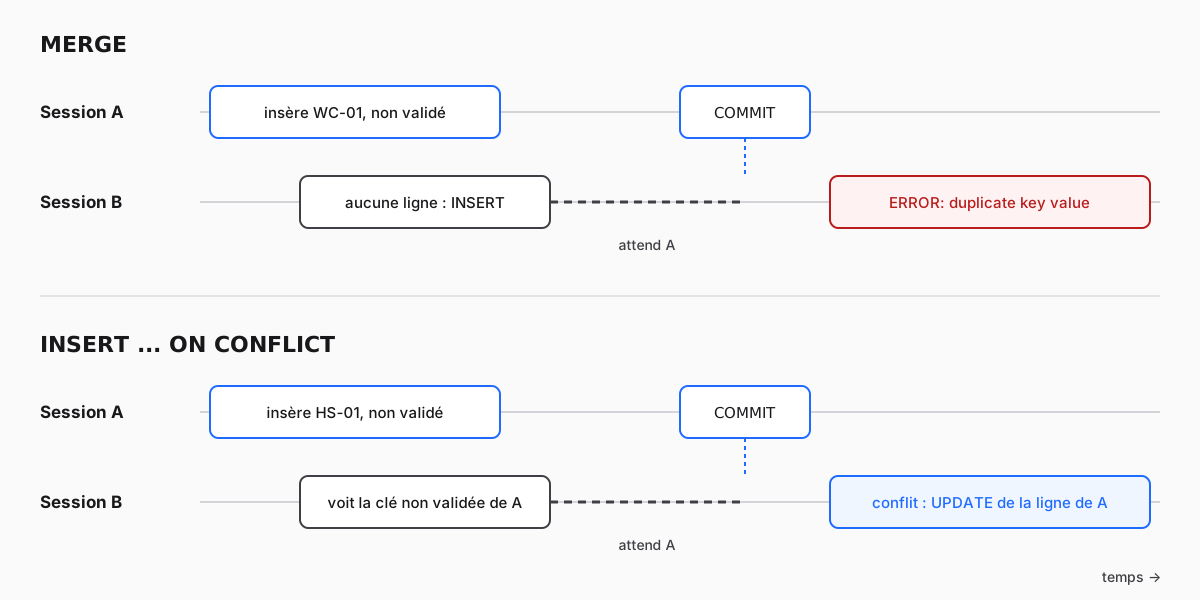
Voici ce qui s’est passé. Quand la session B a démarré, la ligne de A n’était pas validée, si bien que la jointure de B n’a trouvé aucune correspondance et que B a choisi la branche WHEN NOT MATCHED. Son insertion a ensuite attendu sur l’index unique que A se termine. Une fois A validée, la clé existait, et MERGE n’a à ce stade aucun moyen de basculer vers sa branche WHEN MATCHED. La documentation de MERGE le dit d’ailleurs : elle vous renvoie à INSERT ... ON CONFLICT « comme instruction alternative qui offre la possibilité d’exécuter un UPDATE si un INSERT concurrent se produit ».
Voici maintenant la même situation de concurrence avec ON CONFLICT et un autre nouveau SKU :
-- Session A
BEGIN;
INSERT INTO products (sku, name, price) VALUES ('HS-01', 'Headset', 79.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;-- Session B : attend A
INSERT INTO products (sku, name, price) VALUES ('HS-01', 'Headset', 75.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;Après COMMIT; dans la session A, la session B affiche INSERT 0 1, et la ligne contient le prix de B :
SELECT sku, price FROM products WHERE sku IN ('WC-01', 'HS-01') ORDER BY sku; sku | price
-------+-------
HS-01 | 75.00
WC-01 | 59.00WC-01 a gardé le prix de la session A parce que le MERGE de la session B a échoué. Si vous utilisez MERGE sur un chemin où deux écritures peuvent créer la même clé, interceptez le SQLSTATE 23505 et réessayez toute la transaction. Au niveau d’isolation par défaut, READ COMMITTED, la nouvelle tentative prend un nouvel instantané, voit la ligne de A et exécute la branche WHEN MATCHED. Réessayer seulement l’instruction ne fonctionne pas dans une transaction explicite : l’erreur l’a déjà annulée, sauf si vous avez enveloppé le MERGE dans un point de sauvegarde et que vous revenez à celui-ci. Ou bien gardez ce chemin sur ON CONFLICT.
Un upsert par lot qui contient deux fois la même clé échoue en entier :
INSERT INTO products (sku, name, price)
VALUES ('MN-27', 'Monitor', 199.00),
       ('MN-27', 'Monitor 27"', 189.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;ERROR: ON CONFLICT DO UPDATE command cannot affect row a second time
HINT: Ensure that no rows proposed for insertion within the same command have duplicate constrained values.C’est voulu. Postgres ne devine pas laquelle des deux lignes doit l’emporter, il refuse donc d’appliquer les deux. Cela arrive avec des lots construits à partir de flux d’événements ou de fichiers CSV où la même clé apparaît plus d’une fois. Dédoublonnez avant l’insertion et décidez quelle ligne l’emporte. Ici, c’est la dernière ligne du lot qui l’emporte :
INSERT INTO products (sku, name, price)
SELECT DISTINCT ON (sku) sku, name, price
FROM (VALUES ('MN-27', 'Monitor', 199.00, 1),
             ('MN-27', 'Monitor 27"', 189.00, 2)) AS batch(sku, name, price, seq)
ORDER BY sku, seq DESC
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price
RETURNING sku, name, price; sku | name | price
-------+-------------+--------
MN-27 | Monitor 27" | 189.00MERGE applique la même règle, avec un message différent. Deux lignes source qui correspondent à une même ligne cible existante :
MERGE INTO products AS p
USING (VALUES ('KB-01', 'Keyboard', 44.00),
              ('KB-01', 'Keyboard', 43.00)) AS f(sku, name, price)
ON p.sku = f.sku
WHEN MATCHED THEN UPDATE SET price = f.price
WHEN NOT MATCHED THEN INSERT (sku, name, price) VALUES (f.sku, f.name, f.price);ERROR: MERGE command cannot affect row a second time
HINT: Ensure that not more than one source row matches any one target row.Si la clé en double n’existe pas encore dans la table, MERGE prend deux fois la branche WHEN NOT MATCHED, et la seconde insertion échoue alors avec une erreur de clé dupliquée. La correction est la même dans les deux cas : une seule ligne source par clé.
DO NOTHING est la façon naturelle d’écrire « créer la ligne si elle manque », et RETURNING id la façon naturelle d’obtenir l’id. Pour une ligne qui existe déjà, vous n’obtenez rien :
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
ON CONFLICT (sku) DO NOTHING
RETURNING id; id
----
(0 rows)RETURNING ne renvoie que les lignes réellement insérées ou mises à jour. Pour toujours récupérer un id, lisez la ligne existante dans la même instruction :
WITH ins AS (
  INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
  ON CONFLICT (sku) DO NOTHING
  RETURNING id
)
SELECT id FROM ins
UNION ALL
SELECT id FROM products WHERE sku = 'KB-01'
LIMIT 1; id
----
1Il reste une faille. Si une autre session a inséré le même SKU sans l’avoir encore validé, l’INSERT l’attend et ne fait rien, mais la partie SELECT utilise l’instantané pris au démarrage de l’instruction : elle ne peut donc pas voir la nouvelle ligne non plus, et vous obtenez zéro ligne. Traitez un résultat vide comme « réessayer ». L’alternative, DO UPDATE SET sku = EXCLUDED.sku, renvoie toujours la ligne, mais écrit une nouvelle version de ligne à chaque fois, ce qui est le problème de la section 5.
ON CONFLICT (column) ne signifie pas « vérifier les doublons dans cette colonne ». Cela signifie « trouver l’index unique portant exactement sur ces colonnes et l’utiliser ». Nommez une colonne qui n’en a pas, et l’instruction échoue avant de faire quoi que ce soit :
INSERT INTO products (sku, name, price) VALUES ('MS-01', 'Mouse', 19.00)
ON CONFLICT (name) DO NOTHING;ERROR: there is no unique or exclusion constraint matching the ON CONFLICT specificationLe cas moins évident est celui d’un index unique partiel, la manière habituelle de garder les e-mails uniques parmi les comptes qui ne sont pas supprimés logiquement (soft delete) :
CREATE TABLE accounts (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email      text NOT NULL,
  deleted_at timestamptz
);
CREATE UNIQUE INDEX accounts_live_email ON accounts (email) WHERE deleted_at IS NULL;

INSERT INTO accounts (email) VALUES ('ana@example.com')
ON CONFLICT (email) DO NOTHING;ERROR: there is no unique or exclusion constraint matching the ON CONFLICT specificationL’index existe, mais il ne couvre que les lignes où deleted_at IS NULL, donc Postgres ne l’utilise pas tant que vous ne dites pas la même chose dans la cible du conflit :
INSERT INTO accounts (email) VALUES ('ana@example.com')
ON CONFLICT (email) WHERE deleted_at IS NULL DO NOTHING;INSERT 0 1Si votre ORM génère la clause ON CONFLICT, vérifiez s’il sait émettre ce WHERE. Ne remplacez pas l’index partiel par un index unique ordinaire simplement pour satisfaire l’ORM : cela change la règle, et un compte supprimé logiquement garderait alors son e-mail réservé.
DO UPDATE met à jour la ligne dès qu’il y a un conflit, même si toutes les valeurs sont identiques. Dans Postgres, une mise à jour écrit une nouvelle version de ligne, et l’ancienne devient un tuple mort que le vacuum doit nettoyer. Vous pouvez le voir dans xmin, l’id de la transaction qui a écrit la version courante (vos nombres seront différents) :
SELECT xmin, price FROM products WHERE sku = 'KB-01';
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;
SELECT xmin, price FROM products WHERE sku = 'KB-01'; xmin | price
------+-------
742 | 45.00
xmin | price
------+-------
753 | 45.00Même prix, nouvelle version de ligne. Pour une tâche de synchronisation qui renvoie un million de lignes inchangées toutes les heures, cela fait un million de tuples morts par heure, plus le WAL et les éventuels déclencheurs exécutés à la mise à jour. Évitez les mises à jour qui ne changent rien :
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price
WHERE (products.name, products.price) IS DISTINCT FROM (EXCLUDED.name, EXCLUDED.price)
RETURNING id; id
----
(0 rows)xmin reste à 753. Utilisez IS DISTINCT FROM, et non <>, pour qu’un passage depuis ou vers NULL compte comme un changement. Remarquez le RETURNING vide : une ligne que le WHERE écarte est verrouillée mais pas mise à jour, elle n’est donc pas renvoyée, ce qui nous ramène à la section 3.
Après tout ce qui précède, la table contient quatre produits :
SELECT id, sku FROM products ORDER BY id; id | sku
----+-------
1 | KB-01
3 | WC-01
5 | HS-01
9 | MN-27INSERT ... ON CONFLICT construit la ligne qu’il insérerait, y compris la valeur d’identité suivante, avant de vérifier s’il y a un conflit. Chaque upsert qui s’est terminé par une mise à jour, chaque DO NOTHING qui n’a rien fait et chaque tentative d’insertion qui a échoué a consommé un id. Les instructions qui ont échoué avant de tenter d’insérer quoi que ce soit, comme l’erreur ON CONFLICT (name) de la section 4, n’en ont pas consommé. La documentation des séquences signale précisément ce cas. Un MERGE qui aboutit à WHEN MATCHED ne tire pas d’id, mais une insertion MERGE qui échoue en tire un : l’id 4 est allé à la session B dans la section 1.
C’est sans conséquence tant que rien ne traite les ids comme un décompte. Si un chemin d’upsert à fort trafic épuise un id integer 32 bits plus vite que prévu, utilisez bigint, comme le fait la table ci-dessus.
Jusqu’ici, tout fait passer MERGE pour le choix le plus risqué. C’est pourtant le meilleur pour une autre tâche : réconcilier une table avec une source complète. Supposons qu’un fournisseur envoie chaque nuit une liste de prix complète et que vous la chargiez dans une table de staging :
CREATE TABLE price_feed (
  sku   text PRIMARY KEY,
  name  text NOT NULL,
  price numeric(10,2) NOT NULL
);
INSERT INTO price_feed VALUES
  ('KB-01', 'Keyboard',    42.00),
  ('MN-27', 'Monitor 27"', 189.00),
  ('HS-01', 'Headset',     79.00),
  ('MS-01', 'Mouse',       19.00);
Un seul MERGE met à jour ce qui a changé, insère ce qui est nouveau, supprime ce que le fournisseur a retiré, et vous indique laquelle des trois actions a été appliquée à chaque ligne :
MERGE INTO products AS p
USING price_feed AS f
ON p.sku = f.sku
WHEN MATCHED AND (p.name, p.price) IS DISTINCT FROM (f.name, f.price) THEN
  UPDATE SET name = f.name, price = f.price
WHEN NOT MATCHED THEN
  INSERT (sku, name, price) VALUES (f.sku, f.name, f.price)
WHEN NOT MATCHED BY SOURCE THEN
  DELETE
RETURNING merge_action(), p.sku, p.price; merge_action | sku | price
--------------+-------+-------
UPDATE | KB-01 | 42.00
UPDATE | HS-01 | 79.00
INSERT | MS-01 | 19.00
DELETE | WC-01 | 59.00MN-27 est absent de la sortie parce qu’il n’a pas changé. Trois éléments de cette instruction sont nouveaux dans Postgres 17 : RETURNING sur MERGE, la fonction merge_action() et WHEN NOT MATCHED BY SOURCE. Sur Postgres 16, MERGE ... RETURNING est une erreur de syntaxe. Avant la 17, la même synchronisation demandait un upsert, un DELETE ... WHERE NOT EXISTS séparé et un peu de comptabilité pour signaler ce qui avait changé.
WHEN NOT MATCHED BY SOURCE THEN DELETE supprime chaque ligne de la table qui ne figure pas dans la source. Pointez-le vers un flux partiel, ou vers une table de staging vide après un chargement raté, et il supprime des lignes que vous vouliez garder. Vérifiez le nombre de lignes du flux avant de l’exécuter, ou ajoutez une condition sur les colonnes de la cible, par exemple WHEN NOT MATCHED BY SOURCE AND p.supplier = 'acme' THEN DELETE.
La mise en garde de la section 1 sur la concurrence reste valable. Une synchronisation nocturne est généralement la seule à écrire ces clés, c’est pourquoi MERGE lui convient. Si le trafic des requêtes peut insérer les mêmes SKU pendant que la synchronisation s’exécute, réessayez la synchronisation sur 23505.
- Des écritures qui peuvent insérer la même nouvelle clé au même moment :
INSERT ... ON CONFLICT DO UPDATE. - Réconcilier une table avec une source complète, avec mises à jour, insertions et suppressions en une seule passe :
MERGE, avec une nouvelle tentative sur le SQLSTATE23505si quoi que ce soit d’autre écrit ces clés. - Besoin de savoir, ligne par ligne, si elle a été insérée, mise à jour ou supprimée :
MERGE ... RETURNING merge_action()sur Postgres 17. - Lots : dédoublonnez d’abord sur la clé, quelle que soit l’instruction.
- Obtenir ou créer :
DO NOTHINGplus une lecture de la ligne existante, et traitez zéro ligne comme « réessayer ». - Renvoi de données inchangées : ajoutez
WHERE ... IS DISTINCT FROMà la mise à jour. - Index uniques partiels : répétez le
WHEREde l’index dans la cible du conflit.
L’instruction risquée de cet article est celle qui contient DELETE. Avant de pointer un nouveau MERGE vers la production, exécutez-le sur une copie de la production. Sur Relyt One, chaque branche a sa propre instance de calcul au-dessus d’un stockage partagé en copie sur écriture : vous pouvez donc créer une branche de votre base de données, y charger le flux de ce soir dans une table de staging, exécuter le MERGE et lire la sortie de merge_action(). S’il prévoit de supprimer la moitié du catalogue, vous le découvrez sur la branche, et vous jetez la branche. Relyt One exécute PostgreSQL 17, donc RETURNING, merge_action() et WHEN NOT MATCHED BY SOURCE y fonctionnent comme montré ci-dessus.


