
INSERT ... ON CONFLICT vs MERGE en Postgres: qué upsert usar y los errores que lanza cada uno
Cuándo hacer upsert con INSERT ... ON CONFLICT y cuándo usar MERGE en PostgreSQL 17, por qué MERGE puede fallar con un error de clave duplicada bajo concurrencia y cómo resolver 'cannot affect row a second time', un RETURNING vacío y 'no unique or exclusion constraint matching the ON CONFLICT specification'. Cada sentencia reproducida en Postgres 17.11.
En esta página

Postgres tiene dos formas de decir "inserta esta fila o actualízala si ya existe": INSERT ... ON CONFLICT, disponible desde la 9.5, y MERGE, añadido en la 15 y mucho más útil en la 17 gracias a RETURNING, merge_action() y WHEN NOT MATCHED BY SOURCE. Parecen intercambiables y no lo son. Dos sesiones que hacen upsert de la misma clave nueva tienen éxito las dos con ON CONFLICT; con MERGE, una de ellas recibe un error de clave duplicada. Este artículo reproduce esa carrera y los otros cinco errores y sorpresas con los que la gente se topa al hacer upserts, muestra la solución de cada uno y termina con una regla para elegir. Todas las sentencias y todas las salidas de abajo vienen de un PostgreSQL 17.11 local, la versión mayor que ejecuta Relyt One.
Usa INSERT ... ON CONFLICT cuando varios escritores concurrentes puedan insertar la misma clave: un manejador de solicitudes, un consumidor de webhooks, un contador. La documentación de Postgres garantiza "an atomic INSERT or UPDATE outcome; provided there is no independent error, one of those two outcomes is guaranteed, even under high concurrency" (un resultado atómico de INSERT o UPDATE; si no hay un error independiente, uno de esos dos resultados está garantizado, incluso con mucha concurrencia). Usa MERGE cuando concilias un conjunto completo de filas con una tabla, como un feed nocturno o una tabla de staging, y quieres actualizaciones condicionales, borrados o un informe de lo que le pasó a cada fila.
| Te encuentras con | Sentencia | Por qué | Solución |
|---|---|---|---|
duplicate key value violates unique constraint | MERGE | Dos sesiones insertan la misma clave nueva; MERGE no recurre a UPDATE | Usa ON CONFLICT en ese camino, o reintenta ante el SQLSTATE 23505 |
ON CONFLICT DO UPDATE command cannot affect row a second time | INSERT ... ON CONFLICT | El lote contiene la misma clave dos veces | Deduplica el lote con DISTINCT ON |
MERGE command cannot affect row a second time | MERGE | Dos filas de origen coinciden con una fila de destino | Deduplica el origen |
RETURNING vuelve vacío | Ambas | Solo se devuelven las filas que de verdad se insertaron o actualizaron | Lee la fila existente en la misma sentencia |
there is no unique or exclusion constraint matching the ON CONFLICT specification | INSERT ... ON CONFLICT | El destino del conflicto no coincide con un índice único | Añade el índice, o repite el WHERE del índice parcial |
| Filas reescritas sin que nada cambie | Ambas | Una actualización escribe una nueva versión de la fila aunque los valores sean iguales | Añade WHERE ... IS DISTINCT FROM |
| Huecos en tus ids | INSERT ... ON CONFLICT | El id se toma antes de detectar el conflicto | Cuenta con los huecos; no uses los ids como recuento |
Sirve cualquier Postgres 17. Con Docker:
docker run -d --name upsert-lab -e POSTGRES_PASSWORD=secret postgres:17.11-alpine
docker exec -it upsert-lab psql -U postgres
Una tabla, con una columna identity como clave y un sku único:
CREATE TABLE products (
  id    bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  sku   text NOT NULL UNIQUE,
  name  text NOT NULL,
  price numeric(10,2) NOT NULL
);
El upsert básico nombra la columna en conflicto, y EXCLUDED es la fila que intentaste insertar:
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 49.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price
RETURNING id, sku, price, (xmax = 0) AS inserted; id | sku | price | inserted
----+-------+-------+----------
1 | KB-01 | 49.00 | tEjecútalo otra vez con 45.00 y vuelve la misma fila actualizada, con inserted en false:
 id |  sku  | price | inserted
----+-------+-------+----------
  1 | KB-01 | 45.00 | f
La prueba (xmax = 0) es un truco muy copiado para distinguir una inserción de una actualización. Funciona porque una versión de fila recién insertada no tiene xmax, pero depende de cómo guarda Postgres las versiones de fila, no de un comportamiento documentado. MERGE tiene una forma documentada de informar de la acción, que se muestra al final de este artículo.
Abre dos sesiones de psql. En la primera, inicia una transacción y haz upsert con MERGE de un SKU que todavía no existe, pero no hagas commit:
-- Sesión A
BEGIN;
MERGE INTO products AS p
USING (VALUES ('WC-01', 'Webcam', 59.00)) AS f(sku, name, price)
ON p.sku = f.sku
WHEN MATCHED THEN UPDATE SET name = f.name, price = f.price
WHEN NOT MATCHED THEN INSERT (sku, name, price) VALUES (f.sku, f.name, f.price);
En la segunda sesión, ejecuta el mismo MERGE para el mismo SKU. Se queda colgado:
-- Sesión B
MERGE INTO products AS p
USING (VALUES ('WC-01', 'Webcam', 55.00)) AS f(sku, name, price)
ON p.sku = f.sku
WHEN MATCHED THEN UPDATE SET name = f.name, price = f.price
WHEN NOT MATCHED THEN INSERT (sku, name, price) VALUES (f.sku, f.name, f.price);
Escribe COMMIT; en la sesión A. La sesión B se despierta con:
ERROR:  duplicate key value violates unique constraint "products_sku_key"
DETAIL:  Key (sku)=(WC-01) already exists.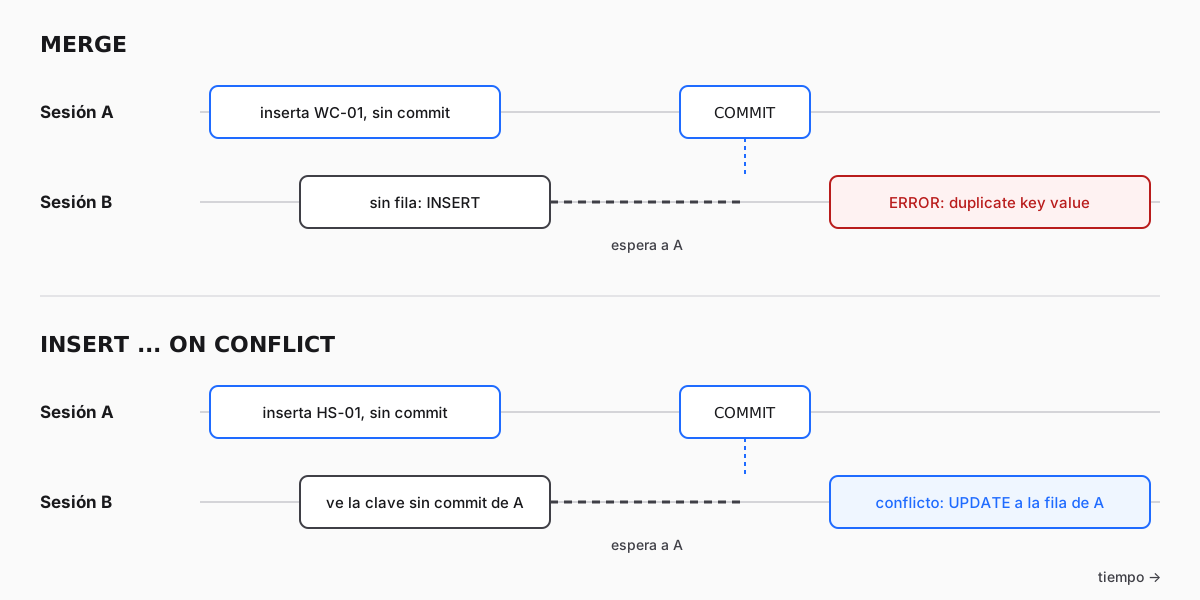
Esto es lo que pasó. Cuando empezó la sesión B, la fila de A no estaba confirmada, así que el join de B no encontró coincidencia y B eligió la rama WHEN NOT MATCHED. Su inserción esperó entonces en el índice único a que A terminara. Una vez que A hizo commit, la clave existía, y MERGE no tiene forma de pasar a su rama WHEN MATCHED en ese punto. La documentación de MERGE lo dice: te remite a INSERT ... ON CONFLICT "as an alternative statement which offers the ability to run an UPDATE if a concurrent INSERT occurs" (como sentencia alternativa que ofrece la posibilidad de ejecutar un UPDATE si se produce un INSERT concurrente).
Ahora la misma carrera con ON CONFLICT y otro SKU nuevo:
-- Sesión A
BEGIN;
INSERT INTO products (sku, name, price) VALUES ('HS-01', 'Headset', 79.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;-- Sesión B: espera a A
INSERT INTO products (sku, name, price) VALUES ('HS-01', 'Headset', 75.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;Tras el COMMIT; en la sesión A, la sesión B imprime INSERT 0 1, y la fila tiene el precio de B:
SELECT sku, price FROM products WHERE sku IN ('WC-01', 'HS-01') ORDER BY sku; sku | price
-------+-------
HS-01 | 75.00
WC-01 | 59.00WC-01 conservó el precio de la sesión A porque el MERGE de la sesión B falló. Si usas MERGE en un camino donde dos escritores pueden crear la misma clave, captura el SQLSTATE 23505 y reintenta la transacción completa. Con el nivel de aislamiento por defecto, READ COMMITTED, el reintento toma un snapshot nuevo, ve la fila de A y ejecuta la rama WHEN MATCHED. Reintentar solo la sentencia no funciona dentro de una transacción explícita: el error ya la abortó, salvo que hayas envuelto el MERGE en un savepoint y vuelvas a él con un rollback. O deja ese camino en ON CONFLICT.
Un upsert por lotes que contiene la misma clave dos veces falla entero:
INSERT INTO products (sku, name, price)
VALUES ('MN-27', 'Monitor', 199.00),
       ('MN-27', 'Monitor 27"', 189.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;ERROR: ON CONFLICT DO UPDATE command cannot affect row a second time
HINT: Ensure that no rows proposed for insertion within the same command have duplicate constrained values.Es intencionado. Postgres no va a adivinar cuál de las dos filas debe ganar, así que se niega a aplicar ambas. Pasa con lotes construidos a partir de flujos de eventos o archivos CSV en los que la misma clave aparece más de una vez. Deduplica antes de la inserción y decide qué fila gana. Aquí gana la fila posterior del lote:
INSERT INTO products (sku, name, price)
SELECT DISTINCT ON (sku) sku, name, price
FROM (VALUES ('MN-27', 'Monitor', 199.00, 1),
             ('MN-27', 'Monitor 27"', 189.00, 2)) AS batch(sku, name, price, seq)
ORDER BY sku, seq DESC
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price
RETURNING sku, name, price; sku | name | price
-------+-------------+--------
MN-27 | Monitor 27" | 189.00MERGE tiene la misma regla con otro mensaje. Dos filas de origen que coinciden con una fila de destino existente:
MERGE INTO products AS p
USING (VALUES ('KB-01', 'Keyboard', 44.00),
              ('KB-01', 'Keyboard', 43.00)) AS f(sku, name, price)
ON p.sku = f.sku
WHEN MATCHED THEN UPDATE SET price = f.price
WHEN NOT MATCHED THEN INSERT (sku, name, price) VALUES (f.sku, f.name, f.price);ERROR: MERGE command cannot affect row a second time
HINT: Ensure that not more than one source row matches any one target row.Si la clave duplicada todavía no existe en la tabla, MERGE toma la rama WHEN NOT MATCHED dos veces y la segunda inserción falla en su lugar con un error de clave duplicada. La solución es la misma en ambos casos: una fila de origen por clave.
DO NOTHING es la forma natural de escribir "créalo si no existe", y RETURNING id la forma natural de obtener el id. Para una fila que ya existe, no obtienes nada:
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
ON CONFLICT (sku) DO NOTHING
RETURNING id; id
----
(0 rows)RETURNING solo devuelve las filas que de verdad se insertaron o actualizaron. Para obtener siempre un id, lee la fila existente en la misma sentencia:
WITH ins AS (
  INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
  ON CONFLICT (sku) DO NOTHING
  RETURNING id
)
SELECT id FROM ins
UNION ALL
SELECT id FROM products WHERE sku = 'KB-01'
LIMIT 1; id
----
1Queda un hueco. Si otra sesión insertó el mismo SKU y todavía no ha hecho commit, el INSERT la espera y no hace nada, pero la parte SELECT usa el snapshot tomado al empezar la sentencia, así que tampoco puede ver la fila nueva, y obtienes cero filas. Trata un resultado vacío como "vuelve a intentarlo". La alternativa, DO UPDATE SET sku = EXCLUDED.sku, siempre devuelve la fila, pero escribe una nueva versión de la fila cada vez, que es el problema de la sección 5.
ON CONFLICT (column) no significa "busca duplicados en esta columna". Significa "encuentra el índice único sobre exactamente estas columnas y úsalo". Nombra una columna que no lo tenga y la sentencia falla antes de hacer nada:
INSERT INTO products (sku, name, price) VALUES ('MS-01', 'Mouse', 19.00)
ON CONFLICT (name) DO NOTHING;ERROR: there is no unique or exclusion constraint matching the ON CONFLICT specificationEl caso menos evidente es un índice único parcial, la forma habitual de mantener los emails únicos entre las cuentas que no tienen borrado lógico:
CREATE TABLE accounts (
  id         bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email      text NOT NULL,
  deleted_at timestamptz
);
CREATE UNIQUE INDEX accounts_live_email ON accounts (email) WHERE deleted_at IS NULL;

INSERT INTO accounts (email) VALUES ('ana@example.com')
ON CONFLICT (email) DO NOTHING;ERROR: there is no unique or exclusion constraint matching the ON CONFLICT specificationEl índice existe, pero solo cubre las filas donde deleted_at IS NULL, así que Postgres no lo usará a menos que digas lo mismo en el destino del conflicto:
INSERT INTO accounts (email) VALUES ('ana@example.com')
ON CONFLICT (email) WHERE deleted_at IS NULL DO NOTHING;INSERT 0 1Si tu ORM genera la cláusula ON CONFLICT, comprueba si puede emitir ese WHERE. No cambies el índice parcial por un índice único normal solo para contentar al ORM: eso cambia la regla, y una cuenta con borrado lógico seguiría teniendo su email ocupado.
DO UPDATE actualiza la fila siempre que hay un conflicto, aunque todos los valores sean iguales. En Postgres, una actualización escribe una nueva versión de la fila, y la anterior se convierte en una tupla muerta que vacuum tiene que limpiar. Puedes verlo en xmin, el id de la transacción que escribió la versión actual (tus números serán distintos):
SELECT xmin, price FROM products WHERE sku = 'KB-01';
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price;
SELECT xmin, price FROM products WHERE sku = 'KB-01'; xmin | price
------+-------
742 | 45.00
xmin | price
------+-------
753 | 45.00Mismo precio, nueva versión de la fila. Para un trabajo de sincronización que reenvía un millón de filas sin cambios cada hora, eso son un millón de tuplas muertas por hora, más el WAL y cualquier trigger que se dispare en las actualizaciones. Omite las actualizaciones que no cambian nada:
INSERT INTO products (sku, name, price) VALUES ('KB-01', 'Keyboard', 45.00)
ON CONFLICT (sku) DO UPDATE SET name = EXCLUDED.name, price = EXCLUDED.price
WHERE (products.name, products.price) IS DISTINCT FROM (EXCLUDED.name, EXCLUDED.price)
RETURNING id; id
----
(0 rows)xmin se queda en 753. Usa IS DISTINCT FROM, no <>, para que un cambio desde o hacia NULL cuente como cambio. Fíjate en el RETURNING vacío: una fila que el WHERE filtra queda bloqueada pero no se actualiza, así que no se devuelve, que es otra vez la sección 3.
Después de todo lo anterior, la tabla tiene cuatro productos:
SELECT id, sku FROM products ORDER BY id; id | sku
----+-------
1 | KB-01
3 | WC-01
5 | HS-01
9 | MN-27INSERT ... ON CONFLICT construye la fila que insertaría, incluido el siguiente valor identity, antes de comprobar si hay conflicto. Cada upsert que terminó actualizando, cada DO NOTHING que no hizo nada y cada intento de inserción que falló consumió un id. Las sentencias que fallaron antes de intentar insertar nada, como el error de ON CONFLICT (name) de la sección 4, no lo consumieron. La documentación de secuencias menciona expresamente este caso. Un MERGE que entra en WHEN MATCHED no toma un id, pero una inserción fallida de MERGE sí: el id 4 se lo llevó la sesión B en la sección 1.
Esto es inofensivo mientras nada trate los ids como un recuento. Si un camino de upsert con mucho tráfico agota un id integer de 32 bits más rápido de lo previsto, usa bigint, como hace la tabla de arriba.
Todo lo anterior hace que MERGE parezca la opción más arriesgada. Es la mejor para otro trabajo: conciliar una tabla con un origen completo. Supón que un proveedor envía cada noche una lista de precios completa y tú la cargas en una tabla de staging:
CREATE TABLE price_feed (
  sku   text PRIMARY KEY,
  name  text NOT NULL,
  price numeric(10,2) NOT NULL
);
INSERT INTO price_feed VALUES
  ('KB-01', 'Keyboard',    42.00),
  ('MN-27', 'Monitor 27"', 189.00),
  ('HS-01', 'Headset',     79.00),
  ('MS-01', 'Mouse',       19.00);
Un solo MERGE actualiza lo que cambió, inserta lo nuevo, elimina lo que el proveedor quitó y te dice cuál de las tres cosas le pasó a cada fila:
MERGE INTO products AS p
USING price_feed AS f
ON p.sku = f.sku
WHEN MATCHED AND (p.name, p.price) IS DISTINCT FROM (f.name, f.price) THEN
  UPDATE SET name = f.name, price = f.price
WHEN NOT MATCHED THEN
  INSERT (sku, name, price) VALUES (f.sku, f.name, f.price)
WHEN NOT MATCHED BY SOURCE THEN
  DELETE
RETURNING merge_action(), p.sku, p.price; merge_action | sku | price
--------------+-------+-------
UPDATE | KB-01 | 42.00
UPDATE | HS-01 | 79.00
INSERT | MS-01 | 19.00
DELETE | WC-01 | 59.00MN-27 no aparece en la salida porque no cambió. Tres partes de esta sentencia son nuevas en Postgres 17: RETURNING en MERGE, la función merge_action() y WHEN NOT MATCHED BY SOURCE. En Postgres 16, MERGE ... RETURNING es un error de sintaxis. Antes de la 17, la misma sincronización requería un upsert, un DELETE ... WHERE NOT EXISTS aparte y algo de contabilidad para informar de lo que cambió.
WHEN NOT MATCHED BY SOURCE THEN DELETE elimina todas las filas de la tabla que no están en el origen. Apúntalo a un feed parcial, o a una tabla de staging vacía tras una carga fallida, y eliminará filas que querías conservar. Comprueba el número de filas del feed antes de ejecutarlo, o añade una condición sobre las columnas del destino, por ejemplo WHEN NOT MATCHED BY SOURCE AND p.supplier = 'acme' THEN DELETE.
La advertencia de concurrencia de la sección 1 sigue vigente. Una sincronización nocturna suele ser el único escritor de esas claves, y por eso MERGE encaja. Si el tráfico de solicitudes puede insertar los mismos SKU mientras corre la sincronización, reintenta la sincronización ante 23505.
- Escritores que pueden insertar la misma clave nueva a la vez:
INSERT ... ON CONFLICT DO UPDATE. - Conciliar una tabla con un origen completo, con actualizaciones, inserciones y borrados en una sola pasada:
MERGE, con un reintento ante el SQLSTATE23505si algo más escribe esas claves. - Necesitas saber, por fila, si se insertó, se actualizó o se eliminó:
MERGE ... RETURNING merge_action()en Postgres 17. - Lotes: deduplica primero por la clave, con cualquiera de las dos sentencias.
- Obtener o crear:
DO NOTHINGmás una lectura de la fila existente, y trata cero filas como "reintentar". - Reenvío de datos sin cambios: añade
WHERE ... IS DISTINCT FROMa la actualización. - Índices únicos parciales: repite el
WHEREdel índice en el destino del conflicto.
La sentencia arriesgada de este artículo es la que lleva DELETE. Antes de apuntar un MERGE nuevo a producción, ejecútalo en una copia de producción. En Relyt One, cada rama tiene su propio cómputo sobre un almacenamiento copy-on-write compartido, así que puedes crear una rama de tu base de datos, cargar allí el feed de esta noche en una tabla de staging, ejecutar el MERGE y leer la salida de merge_action(). Si planea eliminar la mitad del catálogo, lo descubres en la rama, y descartas la rama. Relyt One ejecuta PostgreSQL 17, así que RETURNING, merge_action() y WHEN NOT MATCHED BY SOURCE funcionan allí tal como se muestra arriba.


