
Postgres comme file d’attente de tâches : FOR UPDATE SKIP LOCKED, bien fait
Comment construire une file d’attente de tâches en arrière-plan dans PostgreSQL 17 avec SELECT ... FOR UPDATE SKIP LOCKED : pourquoi le SELECT-puis-UPDATE naïf réserve deux fois la même tâche, pourquoi FOR UPDATE seul fait attendre les workers, baux et nouvelles tentatives, LISTEN/NOTIFY, vacuum, et ce que des workers qui interrogent en boucle font à une instance de calcul serverless. Chaque instruction a été reproduite sur Postgres 17.11.
Sur cette page

Vous n’avez besoin ni de Redis ni d’un courtier de messages pour exécuter des tâches en arrière-plan. Une table Postgres et FOR UPDATE SKIP LOCKED confient chaque tâche à un seul worker à la fois, survivent aux plantages et gardent la tâche dans la même transaction que les données auxquelles elle se rapporte. Le piège, c’est que la première version évidente est fausse : dans notre test, huit workers qui exécutaient un simple « sélectionner la tâche la plus ancienne, puis la mettre à jour » ont réservé les mêmes lignes jusqu’à huit fois et n’ont terminé qu’environ 2 100 tâches sur 10 000. Cet article reproduit ce bogue, construit la file d’attente qui le corrige (réserver, terminer, réessayer, récupérer), et couvre les points qui posent problème plus tard : les transactions laissées ouvertes pendant le travail, LISTEN/NOTIFY, vacuum, et ce que des workers qui interrogent en boucle font à une instance de calcul qui se suspend quand elle est inactive. Chaque instruction et chaque sortie ci-dessous proviennent d’un PostgreSQL 17.11 local, la version majeure qu’exécute Relyt One.
| Symptôme | Cause | Correction |
|---|---|---|
| Deux workers exécutent la même tâche | UPDATE ... WHERE id = (SELECT ... LIMIT 1) sans verrou de ligne | Verrouillez les lignes que vous choisissez : FOR UPDATE SKIP LOCKED |
| Les workers passent chacun leur tour au lieu de travailler en parallèle | FOR UPDATE sans SKIP LOCKED : chaque worker attend celui qui le précède | Ajoutez SKIP LOCKED |
| Vacuum ne nettoie plus, la table grossit | Un worker garde sa transaction ouverte pendant l’exécution de la tâche | Réservez dans une transaction courte et enregistrez un bail |
Une tâche reste running pour toujours après un plantage | Rien ne la récupère | Faites expirer le bail et remettez la tâche dans la file |
| Un worker en retard marque comme terminée une tâche récupérée | La complétion ne vérifie pas à qui appartient la tâche | Protégez la complétion avec le numéro de tentative |
| L’instance de calcul serverless ne se suspend jamais | Un worker interroge la base toutes les quelques secondes | Choisissez délibérément une stratégie d’interrogation (voir la dernière section) |
Une table, une ligne par tâche. L’index partiel ne couvre que les lignes que cherchent les workers, il reste donc petit même quand la table contient un long historique de tâches terminées.
CREATE TABLE jobs (
  id           bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  queue        text        NOT NULL DEFAULT 'default',
  payload      jsonb       NOT NULL,
  status       text        NOT NULL DEFAULT 'queued'
               CHECK (status IN ('queued', 'running', 'done', 'failed')),
  run_at       timestamptz NOT NULL DEFAULT now(),
  attempts     int         NOT NULL DEFAULT 0,
  max_attempts int         NOT NULL DEFAULT 5,
  locked_until timestamptz,
  last_error   text,
  created_at   timestamptz NOT NULL DEFAULT now()
);

CREATE INDEX jobs_ready_idx ON jobs (queue, run_at) WHERE status = 'queued';

INSERT INTO jobs (payload)
SELECT jsonb_build_object('email_id', g) FROM generate_series(1, 10) AS g;
run_at sert aussi de calendrier des nouvelles tentatives : une tâche est prête quand elle est queued et que run_at <= now(). locked_until est le bail, sur lequel nous reviendrons.
C’est la version que la plupart des gens écrivent en premier. Elle semble atomique parce qu’il s’agit d’une seule instruction :
UPDATE jobs
SET status = 'running', attempts = attempts + 1
WHERE id = (
  SELECT id FROM jobs
  WHERE status = 'queued'
  ORDER BY run_at
  LIMIT 1
)
RETURNING id, attempts;
Exécutez-la dans deux sessions en même temps. La session A l’exécute dans une transaction et travaille encore quand la session B exécute la même instruction :
-- session A (inside BEGIN, not committed yet)
 id | attempts
----+----------
  1 |        1

-- session B, returns after A commits
 id | attempts
----+----------
  1 |        2
Les deux sessions ont réservé la tâche 1, et la tâche 2 est toujours queued. Voici pourquoi. La sous-requête s’exécute une seule fois, voit la tâche 1 comme la plus ancienne tâche queued et transmet à l’UPDATE extérieur la valeur id = 1. B doit alors attendre le verrou de ligne de A. En READ COMMITTED, une fois que A a validé, Postgres réévalue la clause WHERE sur la nouvelle version de la ligne. La seule condition restante est id = 1, qui correspond toujours, si bien que B met à jour la tâche que A a déjà prise.
Deux sessions dans un labo, c’est une chose ; nous avons donc lancé huit workers avec pgbench sur 10 000 tâches en attente, à raison de 1 250 réservations par worker :
pgbench -n -c 8 -j 8 -t 1250 -f naive.sql postgresnaive.sql est l’instruction ci-dessus avec status = 'done', si bien que chaque réservation est aussi une complétion. Ensuite :
 status | count | max_attempts
--------+-------+--------------
 done   |  2100 |            8
 queued |  7900 |            0
10 000 réservations ont terminé environ 2 100 tâches (entre 2 068 et 2 137 sur huit exécutions, sur deux machines), et certaines tâches ont été réservées par les huit workers. Dans un vrai système, ce sont huit exemplaires du même e-mail.
Verrouiller les lignes que vous sélectionnez corrige la double réservation. Placez le choix dans une CTE avec FOR UPDATE et faites la mise à jour à travers elle :
WITH next AS (
  SELECT id FROM jobs
  WHERE queue = 'default' AND status = 'queued' AND run_at <= now()
  ORDER BY run_at
  LIMIT 1
  FOR UPDATE
)
UPDATE jobs j
SET status = 'running', attempts = j.attempts + 1
FROM next
WHERE j.id = next.id
RETURNING j.id;
Désormais, la session B se bloque sur la tâche 1. Quand A valide, Postgres revérifie la tâche 1, constate qu’elle ne correspond plus à status = 'queued', l’écarte et passe à la tâche 2. C’est correct, mais regardez le temps de B :
 id
----
  2
(1 row)

UPDATE 1
Time: 1858.126 ms (00:01.858)
B a attendu tout le temps que A a gardé sa transaction ouverte. Avec davantage de workers, ils font la queue derrière la même première ligne et s’exécutent un par un.
Ajoutez deux mots. D’après la référence de SELECT : « With SKIP LOCKED, any selected rows that cannot be immediately locked are skipped. » (avec SKIP LOCKED, toute ligne sélectionnée qui ne peut pas être verrouillée immédiatement est ignorée). La documentation précise aussi à quoi cela sert : cela donne une vue incohérente des données, ce n’est donc pas destiné à un usage général, « but can be used to avoid lock contention with multiple consumers accessing a queue-like table. » (mais peut servir à éviter la contention de verrous quand plusieurs consommateurs accèdent à une table faisant office de file d’attente).
Alors que A détient toujours la tâche 1, B obtient la tâche 2 immédiatement :
 id
----
  2
(1 row)

UPDATE 1
Time: 2.512 ms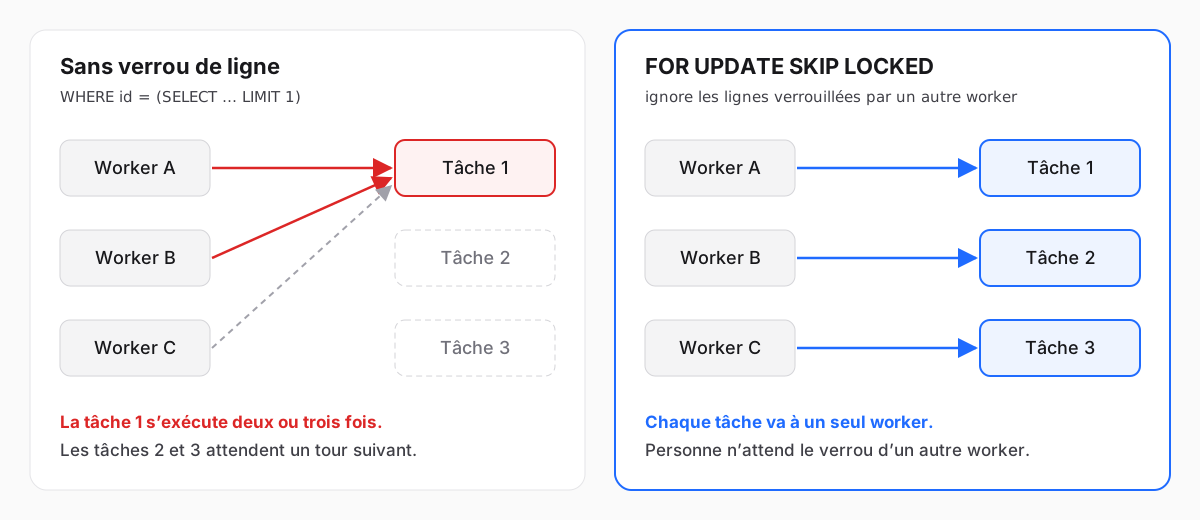
La même exécution de pgbench avec SKIP LOCKED à la place de l’instruction naïve :
 status | count | max_attempts
--------+-------+--------------
 done   | 10000 |            1
Toutes les tâches terminées, chacune exactement une fois.
Voici la réservation que nous utiliserons désormais. Elle prend jusqu’à 10 tâches par aller-retour, ce qui compte dès que chaque tâche est rapide, et écrit un bail :
WITH next AS (
  SELECT id FROM jobs
  WHERE queue = 'default' AND status = 'queued' AND run_at <= now()
  ORDER BY run_at
  LIMIT 10
  FOR UPDATE SKIP LOCKED
)
UPDATE jobs j
SET status       = 'running',
    attempts     = j.attempts + 1,
    locked_until = now() + interval '5 minutes'
FROM next
WHERE j.id = next.id
RETURNING j.id, j.payload, j.attempts;
Sur une table de quelques milliers de lignes, EXPLAIN (COSTS OFF) montre la forme que vous voulez : Limit au-dessus de LockRows au-dessus d’un parcours d’index sur jobs_ready_idx, si bien qu’un worker ne touche que les lignes prêtes et s’arrête après 10.
 Update on jobs j
   CTE next
     ->  Limit
           ->  LockRows
                 ->  Index Scan using jobs_ready_idx on jobs
                       Index Cond: ((queue = 'default'::text) AND (run_at <= now()))
                       Filter: (status = 'queued'::text)
   ->  Nested Loop
         ->  CTE Scan on next
         ->  Index Scan using jobs_pkey on jobs j
Index Cond: (id = next.id)Il y a deux façons d’utiliser cette réservation :
- Verrouiller pendant le travail.
BEGIN, réserver, faire le travail, marquer la tâche comme terminée,COMMIT. Un plantage provoque une annulation et la tâche redevient libre, ce qui est séduisant. - Bail. Réserver et faire
COMMITtout de suite avecstatus = 'running'etlocked_until. Faire le travail en dehors de toute transaction. Marquer la tâche comme terminée dans une seconde transaction courte.
La première convient aux tâches qui prennent quelques millisecondes. Pour tout ce qui appelle une API, envoie un e-mail ou génère un fichier, utilisez le bail. Une transaction qui a écrit quelque chose (c’est le cas d’une réservation) puis reste en attente est idle in transaction, et tant qu’elle est ouverte, vacuum ne peut pas supprimer les versions de lignes devenues mortes après son début, dans aucune table de cette base de données. Une transaction REPEATABLE READ laissée ouverte fait de même, même si elle n’a fait que lire.
Nous avons gardé une réservation ouverte de cette façon, laissé d’autres workers traiter 2 000 tâches, puis exécuté VACUUM (VERBOSE) jobs :
tuples: 0 removed, 11992 remain, 2000 are dead but not yet removableAprès la validation de la transaction ouverte, la même commande :
tuples: 2001 removed, 8542 remain, 0 are dead but not yet removableUne table de file d’attente n’est faite que de mises à jour et de suppressions ; c’est donc la première table à gonfler quand vacuum est bloqué. Une transaction ouverte occupe aussi une connexion serveur, et si vous êtes derrière un pooler en mode transaction, cette connexion sort du pool jusqu’à votre validation. Des transactions courtes évitent les deux problèmes.
Avec des baux, tout le cycle de vie d’une tâche tient en quatre instructions courtes. Celles qu’un worker exécute après la réservation vérifient status = 'running' et attempts, la valeur renvoyée par la réservation, si bien qu’un worker ne peut modifier qu’une tâche qui lui appartient encore.
Terminer. Le worker renvoie l’id et le numéro de tentative qu’il a obtenus lors de la réservation :
UPDATE jobs
SET status = 'done', locked_until = NULL
WHERE id = 1 AND status = 'running' AND attempts = 1;
Échouer et réessayer avec un délai croissant. 20 secondes après le premier échec, 40 après le deuxième, en doublant jusqu’à un plafond d’une heure, puis failed définitivement après max_attempts. Avec la valeur par défaut de 5 tentatives, l’attente la plus longue est de 160 secondes ; le plafond ne compte que si vous augmentez max_attempts.
UPDATE jobs
SET status       = CASE WHEN attempts >= max_attempts THEN 'failed' ELSE 'queued' END,
    run_at       = now() + least(interval '1 hour', interval '10 seconds' * 2 ^ attempts),
    locked_until = NULL,
    last_error   = 'SMTP 451: try again later'
WHERE id = 2 AND status = 'running' AND attempts = 1
RETURNING id, status, attempts, run_at - now() AS retry_in; id | status | attempts | retry_in
----+--------+----------+----------
2 | queued | 1 | 00:00:20Récupérer les baux expirés. Si un worker meurt en pleine tâche, son bail expire et n’importe quel worker (ou une tâche cron) remet la tâche dans la file. Une tâche qui tue son worker à chaque fois reviendrait sinon indéfiniment, c’est pourquoi le récupérateur respecte lui aussi max_attempts :
UPDATE jobs
SET status       = CASE WHEN attempts >= max_attempts THEN 'failed' ELSE 'queued' END,
    locked_until = NULL,
    last_error   = coalesce(last_error, 'lease expired')
WHERE status = 'running' AND locked_until < now()
RETURNING id, status, attempts;
Pourquoi la vérification de la tentative compte. Supposons que le worker de la tâche 3 n’était pas mort, juste lent. Son bail a expiré, le récupérateur a remis la tâche dans la file et un autre worker l’a réservée, si bien que attempts vaut maintenant 2. Quand le worker lent finit enfin et exécute sa complétion avec attempts = 1, il ne se passe rien :
UPDATE 0La tâche reste à son propriétaire actuel. Sans cette vérification, le worker lent marquerait la tâche comme terminée alors que le second worker est encore en train de l’exécuter. Votre traitement doit tout de même être idempotent, car les effets de bord du worker lent ont déjà eu lieu. La vérification se contente de garder l’état de la tâche fidèle à la réalité.
Choisissez un bail plus long que votre tâche normale la plus lente, ou faites en sorte que les tâches longues prolongent leur propre bail au fur et à mesure, et qu’elles s’arrêtent si la prolongation ne met à jour aucune ligne, car la tâche ne leur appartient plus :
UPDATE jobs
SET locked_until = now() + interval '5 minutes'
WHERE id = $1 AND status = 'running' AND attempts = $2;Les workers doivent apprendre qu’il y a du travail. Le plus simple est d’exécuter la réservation en boucle et de dormir quand elle ne renvoie rien. L’alternative est de laisser Postgres les prévenir :
CREATE FUNCTION jobs_notify() RETURNS trigger
LANGUAGE plpgsql AS $$
BEGIN
  PERFORM pg_notify('jobs', NEW.queue);
  RETURN NULL;
END;
$$;

CREATE TRIGGER jobs_notify
AFTER INSERT ON jobs
FOR EACH ROW EXECUTE FUNCTION jobs_notify();
Un worker exécute LISTEN jobs et réserve quand une notification arrive. Trois propriétés tirées de la référence de NOTIFY déterminent la façon de s’en servir :
- La livraison a lieu à la validation. Dans une transaction, les notifications « are not delivered until and unless the transaction is committed. » (ne sont livrées que lorsque la transaction est validée, et seulement si elle l’est). Dans notre test, le producteur a inséré une tâche à 13:08:30 et validé à 13:08:33. La vérification de l’écouteur à 13:08:31 n’a rien vu, et la notification est apparue à sa vérification suivante. C’est ce que vous voulez, car un worker réveillé trop tôt trouverait une tâche qu’il ne peut pas encore voir.
- Les notifications ne sont pas une file d’attente. Seules les sessions qui écoutent à ce moment-là les reçoivent, et les notifications identiques d’une même transaction sont fusionnées en une seule. Traitez une notification comme un « va voir », jamais comme la tâche elle-même, et gardez une interrogation plus lente en secours pour tout ce que vous auriez manqué pendant une reconnexion.
- Les charges utiles sont petites. Dans la configuration par défaut, la charge utile doit faire moins de 8000 octets. Envoyez le nom de la file ou un id, pas la tâche.
Un dernier point : LISTEN appartient à une connexion serveur, il lui faut donc une connexion directe, pas une connexion qui passe par un pooler en mode transaction. Nous avons expliqué pourquoi dans Ce qui casse derrière le pooling en mode transaction de PgBouncer, et comment corriger chaque cas. Les producteurs et les requêtes de réservation peuvent utiliser la connexion poolée.
Sur Relyt One, une instance de calcul qui n’a rien eu à faire pendant une dizaine de minutes se suspend, et la connexion suivante la réactive. Pour une file d’attente, ce qui compte, c’est ce qui est considéré comme « quelque chose à faire ». Le moniteur d’activité de l’instance de calcul vérifie les sessions clientes toutes les demi-secondes :
- toute session qui n’est pas
idle(qui exécute une requête, ou qui estidle in transaction) compte comme une activité en ce moment même ; - une session
idlecompte comme une activité à la date de son dernier changement d’état, c’est-à-dire quand sa dernière requête s’est terminée ; - un worker autovacuum en cours d’exécution, ou une connexion de réplication logique active, maintient aussi l’instance de calcul éveillée.
Ainsi, un worker qui interroge la base toutes les secondes, ou toutes les cinq minutes, maintient l’instance de calcul éveillée en permanence, même si la file reste vide toute la nuit. Un worker qui garde une transaction ouverte pendant son travail la maintient éveillée pendant toute la tâche. Une connexion inactive seule ne le fait pas, car son dernier changement d’état ne cesse de vieillir. Trois conséquences en découlent. Une suspension ferme toutes les connexions, y compris une connexion en LISTEN, et un worker qui se reconnecte aussitôt réactive l’instance de calcul. Les requêtes de contrôle de santé d’un pilote ou d’un pool comptent comme une activité. Et une interrogation de secours qui s’exécute plus souvent que toutes les dix minutes garde l’instance de calcul allumée.
Cela vous laisse trois options honnêtes :
- Les tâches doivent démarrer en quelques secondes. Acceptez une instance de calcul toujours allumée tant que les workers tournent. C’est le prix d’une faible latence sur n’importe quelle plateforme. Interrogez la base à un intervalle que vous pouvez accepter, ou utilisez
LISTENavec une interrogation de secours. - Les tâches peuvent attendre un moment. Ne faites pas tourner les workers en permanence. Lancez-les selon un calendrier qui laisse des intervalles plus longs que le délai d’inactivité, faites-leur vider la file avec la réservation par lot, puis arrêtez-les. Entre deux exécutions, l’instance de calcul peut se suspendre, et la première connexion de l’exécution suivante la réactive.
- Les tâches viennent de votre propre application. Faites en sorte que la requête qui met une tâche en file déclenche aussi un worker (une fonction serverless, une tâche dans l’exécuteur de tâches de votre plateforme). La base de données reste la source de vérité pour l’état, les nouvelles tentatives et les baux, et rien n’a besoin d’interroger la base.
Les branches aident aussi. Chaque branche a sa propre instance de calcul : vous pouvez donc diriger une flotte de workers de test vers une branche contenant une copie des données de production, bombarder la requête de réservation, et laisser tranquille l’instance de calcul de production.
Les tâches terminées n’ont pas besoin de rester dans la table active. Supprimez-les par lots, ou déplacez-les vers une table d’archive, de façon planifiée :
DELETE FROM jobs
WHERE id IN (
  SELECT id FROM jobs
  WHERE status = 'done' AND created_at < now() - interval '7 days'
  LIMIT 10000
);
Chaque réservation, complétion et nouvelle tentative écrit une nouvelle version de ligne, si bien que la table produit des tuples morts en continu. Surveillez n_dead_tup et last_autovacuum dans pg_stat_user_tables pour jobs, et gardez des transactions courtes pour que vacuum puisse réellement supprimer ce qu’il trouve.
Une table de tâches convient bien quand les tâches se rapportent à des lignes de la même base de données, que le débit reste de l’ordre d’un UPDATE par tâche, et que vous voulez que la mise en file fasse partie de la même transaction que la modification des données. Ce dernier point, un courtier externe ne peut pas vous l’offrir sans mécanisme supplémentaire. Elle convient mal à la diffusion vers de nombreux consommateurs indépendants, à la conservation d’un flux pour le rejouer plus tard, ou aux volumes où le renouvellement des lignes par les mises à jour devient lui-même le goulot d’étranglement. Utilisez un courtier ou un journal pour ces cas.
- Réservez avec une CTE et
FOR UPDATE SKIP LOCKED, jamais avecWHERE id = (SELECT ... LIMIT 1)sans verrou - Utilisez un index partiel sur la condition « prête »
- Réservez et validez tout de suite ; enregistrez
locked_until; faites le travail en dehors de la transaction - Terminez, échouez et prolongez avec
WHERE id = $1 AND status = 'running' AND attempts = $2, et vérifiez le nombre de lignes - Faites tourner un récupérateur pour les baux expirés ; plafonnez les nouvelles tentatives avec
max_attempts - Utilisez
LISTENsur une connexion directe, traitez les notifications comme des indices, gardez une interrogation de secours - Supprimez ou archivez les tâches terminées ; surveillez
n_dead_tup - Décidez comment les workers attendent, en sachant ce qui maintient une instance de calcul serverless éveillée
Chaque instruction de cet article est du SQL PostgreSQL 17 standard, sans extension. Créez un projet Relyt One gratuit, ouvrez une branche et connectez-y deux sessions psql pour voir SKIP LOCKED leur attribuer des lignes différentes.


