
Pourquoi les identifiants Postgres sautent des numéros, et comment corriger les erreurs « duplicate key » après une importation
D’où viennent les trous dans les colonnes serial et identity de PostgreSQL (annulations, ON CONFLICT, plantages, CACHE), pourquoi les insertions échouent avec duplicate key value violates unique constraint après une importation de données, une requête qui réinitialise toutes les séquences, l’épuisement des identifiants integer et des numéros de facture sans trous. Chaque instruction a été reproduite sur Postgres 17.11.
Sur cette page

Deux questions sur les identifiants Postgres reviennent sans cesse. « Pourquoi mes identifiants sont-ils passés de 5 à 34 ? » et « Pourquoi chaque insertion échoue-t-elle avec duplicate key value violates unique constraint \"..._pkey\" juste après l’importation de mes données ? » Les deux viennent du même objet : la séquence derrière votre colonne serial ou identity. Une séquence distribue des numéros sans se soucier de savoir si vous les utilisez, les trous sont donc normaux. Et elle ne connaît que les numéros qu’elle a elle-même distribués, si bien que les lignes que vous chargez avec des identifiants explicites la laissent derrière. Cet article reproduit chaque type de trou, corrige l’erreur d’importation pour une table puis pour toutes les tables d’un coup, montre ce qui se passe quand un identifiant integer est épuisé, et construit une numérotation sans trous pour le seul endroit où vous pourriez vraiment en avoir besoin. Chaque instruction et chaque sortie ci-dessous proviennent d’un PostgreSQL 17.11 local, la version majeure qu’exécute Relyt One.
| Symptôme | Cause | Correction |
|---|---|---|
| Les identifiants sautent quelques numéros | Insertions annulées ou échouées, ON CONFLICT | Rien. Les séquences ne sont pas sans trous, par conception |
| Les identifiants font un bond allant jusqu’à 32 après un plantage (avec le cache par défaut) | Les séquences journalisent des valeurs à l’avance dans le WAL | Rien. Ne donnez pas de sens aux valeurs des identifiants |
| Les identifiants de différentes sessions s’entremêlent ou font des bonds de la taille du cache | CACHE supérieur à 1 | Utilisez la valeur par défaut CACHE 1 si l’ordre compte |
duplicate key value violates unique constraint après une importation | Les lignes ont été chargées avec des identifiants explicites ; la séquence commence toujours à 1 | Placez la séquence au-delà de max(id) avec setval |
nextval: reached maximum value of sequence | Une colonne serial est un integer 32 bits | Passez la séquence et la colonne en bigint |
| Vous avez besoin de numéros de facture sans trous | Les séquences ne peuvent pas vous les donner | Une ligne de compteur mise à jour dans la même transaction |
La documentation de PostgreSQL est sans détour : la valeur que renvoie nextval « is not reclaimed for re-use if the calling transaction later aborts » (n’est pas récupérée pour être réutilisée si la transaction appelante est annulée par la suite), et « sequence objects cannot be used to obtain 'gapless' sequences. » (les objets séquence ne peuvent pas servir à obtenir des séquences « sans trous »). C’est un compromis délibéré. Si une transaction annulée pouvait rendre son numéro, toutes les autres transactions qui demandent un numéro devraient attendre de savoir si elle l’a fait. Voici comment les trous apparaissent en pratique.
CREATE TABLE orders (
  id    bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  email text NOT NULL UNIQUE
);

INSERT INTO orders (email) VALUES ('a@example.com');           -- prend 1

BEGIN;
INSERT INTO orders (email) VALUES ('b@example.com');           -- prend 2
ROLLBACK;                                                      -- 2 est perdu

INSERT INTO orders (email) VALUES ('c@example.com');           -- prend 3
INSERT INTO orders (email) VALUES ('a@example.com')
  ON CONFLICT (email) DO NOTHING;                              -- consomme 4
INSERT INTO orders (email) VALUES ('a@example.com');           -- consomme 5, échoue
INSERT INTO orders (email) VALUES ('d@example.com');           -- prend 6

SELECT id, email FROM orders ORDER BY id; id | email
----+---------------
1 | a@example.com
3 | c@example.com
6 | d@example.com
(3 rows)Trois lignes, trois trous. L’insertion annulée a pris 2. L’insertion qui a échoué sur la contrainte unique email a pris 5 avant d’échouer : Postgres construit la ligne entière, y compris l’identifiant par défaut, avant de vérifier les contraintes. ON CONFLICT DO NOTHING a pris 4 sans rien insérer, pour la même raison. La documentation le dit explicitement : INSERT ... ON CONFLICT calcule la ligne, « including doing any required nextval calls, before detecting any conflict. » (y compris les appels à nextval nécessaires, avant de détecter le moindre conflit). Si votre application fait des upserts sur les mêmes lignes encore et encore, la séquence peut grimper bien plus vite que le nombre de lignes. (Nous avons couvert les upserts en détail dans INSERT ... ON CONFLICT vs MERGE.)
Écrire un enregistrement WAL à chaque nextval serait lent, donc Postgres journalise une séquence à l’avance : quand il écrit un enregistrement, il y inscrit une valeur située 32 numéros plus loin et distribue les numéros intermédiaires sans journaliser à nouveau. La constante est SEQ_LOG_VALS dans le code source du serveur, et le commentaire qui l’accompagne dit : « In the event of crash we can lose (skip over) as many values as we pre-logged. » (en cas de plantage, nous pouvons perdre (sauter) autant de valeurs que nous en avons journalisé à l’avance).
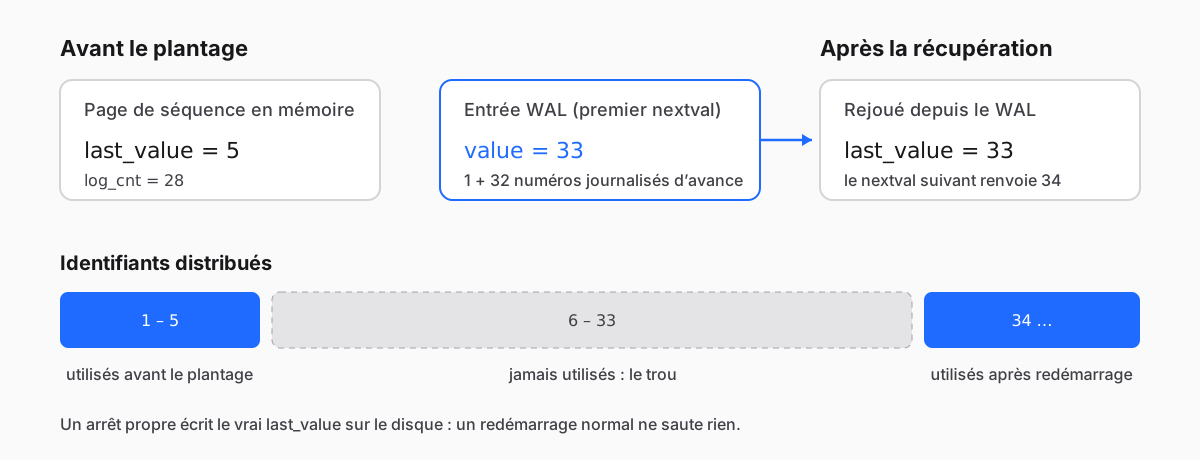
Vous pouvez l’observer. log_cnt est le nombre de valeurs journalisées à l’avance qui restent :
CREATE TABLE events (
  id   bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  note text
);
INSERT INTO events (note) SELECT 'before crash' FROM generate_series(1, 5);
SELECT last_value, log_cnt FROM events_id_seq; last_value | log_cnt
------------+---------
5 | 28
(1 row)Faites maintenant planter le serveur sans arrêt propre (pg_ctl stop -m immediate), redémarrez-le et insérez une ligne de plus :
LOG: database system was not properly shut down; automatic recovery in progressINSERT INTO events (note) VALUES ('after crash') RETURNING id; id
----
34
(1 row)La récupération a rejoué le WAL, le WAL disait 33, donc l’identifiant suivant est 34. Les numéros 6 à 33 n’ont jamais été utilisés. Postgres écrit aussi un nouvel enregistrement de 32 valeurs au premier nextval après chaque checkpoint, si bien que le nombre de numéros perdus dépend de l’endroit de cette fenêtre où survient le plantage. Les 32 s’ajoutent au cache : une séquence avec CACHE 20 (section suivante) journalise 20 + 32 valeurs à l’avance et peut en perdre autant.
Un arrêt propre écrit l’état réel sur le disque, et dans notre test un redémarrage normal a repris au numéro suivant. Il s’agissait d’un serveur Postgres ordinaire que nous avons arrêté nous-mêmes ; la façon dont les redémarrages ont lieu sur un service managé dépend du service, alors considérez tout redémarrage comme un bond possible.
Une séquence créée avec CACHE 20 donne à chaque session 20 numéros à la fois. Les numéros qu’une session n’utilise pas sont perdus quand elle se déconnecte :
CREATE SEQUENCE ticket_seq CACHE 20;
SELECT nextval('ticket_seq');    -- la session 1 réserve 1..20
\c
SELECT nextval('ticket_seq'); -- la session 2 réserve 21..40 nextval
---------
1
(1 row)
You are now connected to database "postgres" as user "postgres".
nextval
---------
21
(1 row)Avec un cache, la documentation avertit aussi que les numéros de différentes sessions ne sont plus distribués dans l’ordre chronologique : la session A obtient 1, la session B obtient ensuite 21, et seulement après cela A obtient 2. La valeur par défaut est CACHE 1, celle qu’utilisent les colonnes serial et identity à moins que vous ne la changiez.
Aucun de ces trous n’est un bogue, et aucun n’a besoin d’être corrigé. La correction se fait dans votre tête : un identifiant dit « cette ligne est différente de celle-là », pas « c’était la 6e commande » ni « il y a 6 commandes ».
Celui-ci est un vrai bogue, et il se manifeste en général le premier jour après une migration : vous avez exporté une table d’une base de données, l’avez chargée dans une autre, et la première insertion de l’application échoue. Voici le tout en trois instructions :
CREATE TABLE customers (
  id   serial PRIMARY KEY,
  name text NOT NULL
);

-- ce que fait une importation CSV, un seed d’ORM ou une copie depuis une autre base :
COPY customers (id, name) FROM stdin;
1	Ada
2	Grace
3	Edsger
\.

INSERT INTO customers (name) VALUES ('Barbara');ERROR: duplicate key value violates unique constraint "customers_pkey"
DETAIL: Key (id)=(1) already exists.Les lignes portent leurs propres identifiants, donc COPY n’a jamais appelé nextval. La séquence croit toujours que rien n’a été distribué, donne 1 à la nouvelle ligne, et la clé primaire la rejette. Les colonnes identity se comportent de la même façon : COPY écrit les identifiants de l’entrée même dans une colonne GENERATED ALWAYS, « like the INSERT option OVERRIDING SYSTEM VALUE » (comme l’option OVERRIDING SYSTEM VALUE d’INSERT), et la séquence n’avance pas.
Un détail rend la chose déroutante : chaque insertion échouée consomme quand même un numéro. Réessayez trois fois et la quatrième insertion réussit, parce que la séquence a enfin dépassé les identifiants importés. C’est pourquoi l’erreur se « corrige parfois toute seule » en développement, où vous avez importé trois lignes, et pas en production, où vous en avez importé trois millions.
Placez la séquence sur l’identifiant le plus élevé de la table. pg_get_serial_sequence trouve la séquence derrière une colonne serial ou identity, vous n’avez donc pas à deviner son nom :
SELECT pg_get_serial_sequence('customers', 'id');
SELECT setval(pg_get_serial_sequence('customers', 'id'), max(id)) FROM customers;
INSERT INTO customers (name) VALUES ('Barbara') RETURNING id; pg_get_serial_sequence
-------------------------
public.customers_id_seq
(1 row)
setval
--------
3
(1 row)
id
----
4
(1 row)Deux choses tournent mal avec cette ligne unique. Sur une table vide, max(id) vaut NULL, et setval avec un argument NULL renvoie NULL et ne fait rien, sans prévenir. Et setval(seq, 0) échoue, parce que le minimum par défaut d’une séquence est 1 :
CREATE TABLE audit_log (id bigint GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY);
SELECT setval(pg_get_serial_sequence('audit_log', 'id'), max(id)) FROM audit_log;
SELECT setval(pg_get_serial_sequence('audit_log', 'id'), 0); setval
--------
(1 row)
ERROR: setval: value 0 is out of bounds for sequence "audit_log_id_seq" (1..9223372036854775807)La forme qui gère la table vide est setval(seq, COALESCE(max(id), 0) + 1, false). Le false signifie « le prochain nextval renvoie exactement cette valeur », si bien qu’une table vide commence à 1.
Notez aussi que setval n’est pas transactionnel : la documentation indique que sa modification est « immediately visible to other transactions, and [is] not undone if the calling transaction rolls back. » (immédiatement visible par les autres transactions, et n’est pas défaite si la transaction appelante est annulée).
Après une importation en masse, vous voulez faire cela pour chaque table. Cette requête trouve chaque séquence qui appartient à une colonne serial ou identity, construit un setval pour chacune, et \gexec dans psql exécute les instructions générées. Chaque setval ne fait qu’avancer une séquence : il prend la plus élevée des deux valeurs, max(id) + 1 ou la valeur que la séquence distribuerait ensuite. Cela compte sur une base de données déjà en service. Si vous avez supprimé les lignes les plus récentes d’une table, max(id) + 1 est inférieur à la séquence, et faire reculer la séquence distribuerait des identifiants qui ont déjà été utilisés une fois et peuvent encore être référencés ailleurs.
SELECT format(
         'SELECT setval(%1$L, GREATEST('
         'COALESCE((SELECT max(%2$I) FROM %3$I.%4$I), 0) + 1, '
         '(SELECT last_value + is_called::int FROM %1$s)), false);',
         s.oid::regclass, a.attname, n.nspname, t.relname)
FROM pg_class s
JOIN pg_depend d    ON d.classid = 'pg_class'::regclass
                   AND d.objid = s.oid
                   AND d.refclassid = 'pg_class'::regclass
                   AND d.deptype IN ('a', 'i')   -- serial / identity
JOIN pg_class t     ON t.oid = d.refobjid
JOIN pg_namespace n ON n.oid = t.relnamespace
JOIN pg_attribute a ON a.attrelid = t.oid AND a.attnum = d.refobjsubid
WHERE s.relkind = 'S'
ORDER BY 1
\gexec
Sur notre base de test, elle a généré et exécuté une instruction par table. En voici deux (sortie abrégée), la table vide audit_log et la table importée customers :
SELECT setval('audit_log_id_seq', GREATEST(COALESCE((SELECT max(id) FROM public.audit_log), 0) + 1, (SELECT last_value + is_called::int FROM audit_log_id_seq)), false);
 setval
--------
      1
(1 row)

SELECT setval('customers_id_seq', GREATEST(COALESCE((SELECT max(id) FROM public.customers), 0) + 1, (SELECT last_value + is_called::int FROM customers_id_seq)), false);
 setval
--------
      5
(1 row)
Exécutez-la après l’importation et avant de laisser entrer le trafic ; une ligne insérée entre max(id) et setval peut encore entrer en collision. Comme la propre valeur suivante de la séquence fait partie du GREATEST, une séquence avec un MINVALUE ou un START personnalisé supérieur à 1 sur une table vide reste où elle est au lieu d’échouer. \gexec continue après une erreur, alors exécutez-la avec \set ON_ERROR_STOP on si vous voulez que le premier échec arrête le reste. Deux cas ne sont pas couverts. Les séquences décroissantes (INCREMENT négatif) nécessitent min et LEAST à la place. Et une séquence qu’une colonne utilise seulement via DEFAULT nextval('some_seq'), sans OWNED BY, n’appartient pas à la colonne : pg_get_serial_sequence renvoie NULL pour elle, et la requête ci-dessus l’ignore. Corrigez celles-là à la main.
| Comment les données sont arrivées | Séquences |
|---|---|
pg_dump de toute la base de données, restauré avec psql ou pg_restore | Correctement positionnées. Le dump contient un setval pour chaque séquence |
pg_dump --data-only | Correctement positionnées. Les dumps de données seules incluent aussi les appels à setval |
pg_dump -t <table> | Les séquences que la table possède (serial, identity) sont incluses avec leur setval. Une séquence que la table référence seulement via DEFAULT nextval(...) ne l’est pas : la restauration dans une base de données qui ne l’a pas échoue, et dans une base qui l’a, cette séquence n’avance pas |
COPY ou \copy depuis un CSV, fichiers de seed d’ORM, script qui insère des lignes avec leurs identifiants | Non positionnées. Appliquez la correction ci-dessus |
| Réplication logique | Non positionnées. « Sequence data is not replicated » (les données des séquences ne sont pas répliquées) : les séquences de l’abonné restent à leur valeur de départ jusqu’à ce que vous les mettiez à jour avant la bascule |
TRUNCATE puis rechargement | TRUNCATE ne réinitialise pas les séquences sauf si vous ajoutez RESTART IDENTITY ; recharger les mêmes identifiants ne pose pas de problème, charger de nouveaux identifiants plus élevés nécessite la correction |
Nous avons vérifié chaque ligne avec pg_dump 17.11. La documentation explique le cas DEFAULT nextval(...) : avec -t, « pg_dump makes no attempt to dump any other database objects that the selected table(s) might depend upon. » (pg_dump ne tente pas de sauvegarder les autres objets de la base dont la ou les tables sélectionnées pourraient dépendre).
serial crée une colonne integer et une séquence integer, elle s’arrête donc à 2 147 483 647. Cela paraît beaucoup jusqu’à ce qu’une table qui journalise des événements ou fait des upserts en masse consomme des numéros plus vite qu’elle ne stocke de lignes (voir les trous ci-dessus). Voici à quoi ressemble la fin :
CREATE TABLE clicks (id serial PRIMARY KEY);
SELECT setval('clicks_id_seq', 2147483646);     -- avance rapide pour la démo
INSERT INTO clicks DEFAULT VALUES RETURNING id;
INSERT INTO clicks DEFAULT VALUES RETURNING id; id
------------
2147483647
(1 row)
ERROR: nextval: reached maximum value of sequence "clicks_id_seq" (2147483647)Vérifiez à quel point vous en êtes proche avant que cela n’arrive. pg_sequences affiche chaque séquence avec son type et sa limite :
SELECT schemaname, sequencename, data_type, last_value, max_value,
       round(100.0 * last_value / max_value, 2) AS pct_used
FROM pg_sequences
ORDER BY pct_used DESC NULLS LAST, sequencename
LIMIT 3; schemaname | sequencename | data_type | last_value | max_value | pct_used
------------+------------------+-----------+------------+---------------------+----------
public | clicks_id_seq | integer | 2147483647 | 2147483647 | 100.00
public | ticket_seq | bigint | 40 | 9223372036854775807 | 0.00
public | audit_log_id_seq | bigint | | 9223372036854775807 |
(3 rows)Notez ticket_seq à 40 : avec CACHE 20, last_value inclut des numéros que des sessions ont réservés mais pas encore utilisés. Et last_value vaut NULL pour une séquence qui n’a pas distribué de numéro depuis un setval(..., false), comme celles que la correction ci-dessus vient de toucher ; elles sont triées en dernier.
Cette requête ne connaît que la limite propre à la séquence. Si la séquence est en bigint mais que la colonne est toujours en integer, la colonne échoue en premier alors que la requête affiche presque 0 %. C’est exactement le piège suivant.
Changer seulement la séquence ne suffit pas, car la colonne est toujours un integer :
ALTER SEQUENCE clicks_id_seq AS bigint;
INSERT INTO clicks DEFAULT VALUES RETURNING id;ERROR: integer out of rangeLa colonne doit changer aussi, avec ALTER TABLE clicks ALTER COLUMN id TYPE bigint. Sur une grosse table, cette instruction réécrit toute la table en tenant un verrou ACCESS EXCLUSIVE, qui bloque les lectures et les écritures pendant toute sa durée. Notre article sur les migrations qui verrouillent votre table mesure exactement ce changement. La correction bon marché est celle que vous faites dès le premier jour : utilisez bigint pour les identifiants.
Parfois le métier a besoin de numéros sans trous, les numéros de facture étant l’exemple habituel. Une séquence ne peut pas le faire, alors utilisez une ligne que vous mettez à jour dans la même transaction que l’insertion. Avec le niveau d’isolation par défaut READ COMMITTED, le verrou de ligne fait passer les transactions concurrentes chacune leur tour, et une annulation défait l’incrément en même temps que la facture :
CREATE TABLE invoice_counters (
  year    int PRIMARY KEY,
  last_no int NOT NULL
);
INSERT INTO invoice_counters VALUES (2026, 0);

CREATE TABLE invoices (
  id     bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
  year   int NOT NULL,
  no     int NOT NULL,
  amount numeric NOT NULL,
  UNIQUE (year, no)
);

BEGIN;
WITH n AS (
  UPDATE invoice_counters SET last_no = last_no + 1
  WHERE year = 2026
  RETURNING last_no
)
INSERT INTO invoices (year, no, amount)
SELECT 2026, last_no, 120 FROM n
RETURNING id, year, no;
ROLLBACK;
Exécutez à nouveau la même transaction avec COMMIT au lieu de ROLLBACK :
 id | year | no
----+------+----
  2 | 2026 |  1
(1 row)
Le numéro de facture est de nouveau 1, car l’annulation a défait le compteur. L’id vaut 2, car la colonne identity reste une séquence et a perdu 1 à cause de l’annulation. Gardez les deux : l’identity comme clé primaire, le numéro sans trous comme champ métier.
Le prix à payer, c’est la concurrence. Une seule transaction à la fois peut détenir la ligne de compteur. Dans notre test, une session l’a détenue pendant cinq secondes, et une seconde session démarrée environ une seconde plus tard a vu son UPDATE attendre que la première valide :
 last_no
---------
       3
(1 row)

UPDATE 1
Time: 3943.462 ms (00:03.943)
Gardez donc ces transactions courtes : prenez le numéro en dernier, juste avant le COMMIT, et n’appelez pas d’autres services pendant que vous le détenez. Une ligne de compteur par année (ou par série, par locataire) répartit aussi l’attente. En REPEATABLE READ ou SERIALIZABLE, la seconde transaction attend toujours, mais quand la première valide, elle échoue avec could not serialize access due to concurrent update, et votre code doit la réessayer.
Pour les nouvelles tables, utilisez bigint GENERATED ALWAYS AS IDENTITY. C’est la syntaxe du standard SQL, la colonne et sa séquence sont liées, et GENERATED ALWAYS refuse les identifiants explicites accidentels :
ERROR:  cannot insert a non-DEFAULT value into column "id"
DETAIL:  Column "id" is an identity column defined as GENERATED ALWAYS.
HINT:  Use OVERRIDING SYSTEM VALUE to override.
La page « Don't Do This » du wiki de la communauté PostgreSQL dit la même chose : « For new applications, identity columns should be used instead » (pour les nouvelles applications, il faut plutôt utiliser des colonnes identity) de serial. Tout ce que cet article dit sur les trous et les importations s’applique aux deux ; seule la protection lors de l’importation diffère, et comme montré plus haut, COPY la contourne de toute façon.
Le bogue d’importation est facile à corriger et facile à manquer, car il n’apparaît qu’à la première insertion après l’arrivée des données. Testez cette insertion avant vos utilisateurs. Sur Relyt One, une branche est une nouvelle ligne d’historique qui part de sa branche parente à un instant donné, partage ses pages en copie à l’écriture et dispose de sa propre instance de calcul. Chargez votre export dans une branche, exécutez la requête qui corrige toutes les séquences, insérez une ligne dans chaque table et regardez dans pg_sequences si quelque chose approche de sa limite. Les écritures sur une branche ne touchent pas sa branche parente, les séquences de la branche avancent donc de leur côté ; si quelque chose tourne mal, supprimez la branche et recommencez.
Relyt One exécute PostgreSQL 17, et le SQL de cet article ne nécessite aucune extension. Les lignes \c et \gexec sont des commandes psql, et le test de plantage nécessite un serveur Postgres que vous pouvez arrêter vous-même : exécutez donc celui-là en local.


